新模型模板准备与端到端部署调用指引
环境与参数说明
本指引使用当前环境页面中的菜单、字段和状态名称。模型 ID、模型提供方实例 ID、服务端口和可选发布范围可能因环境而异,请以当前页面显示的值为准。
根据实际业务诉求,本场景提供以下两条操作链路:
- 场景 A:使用已有模板启动并调用模型(模型提供方):当运营管理员已完成算力模板准备时,模型提供方可直接使用已就绪的模板创建模型实例,并完成发布、Playground 对话体验与 API 调用测试。
- 场景 B:端到端准备新模板并部署调用(运营管理员 + 模型提供方):当需要引入新开源模型时,由运营管理员完成模型权重下载与昇腾 910B 推理模板制作,再由模型提供方基于新模板完成实例部署与调用验证。
场景 A:使用已有模板启动并调用模型
1. 使用模板创建模型实例(模型提供方)
使用模型提供方账号登录,进入 模型服务 > 我的模型 (My Models) 页面,点击目标模型卡片上的 Start,使用模板创建模型实例。
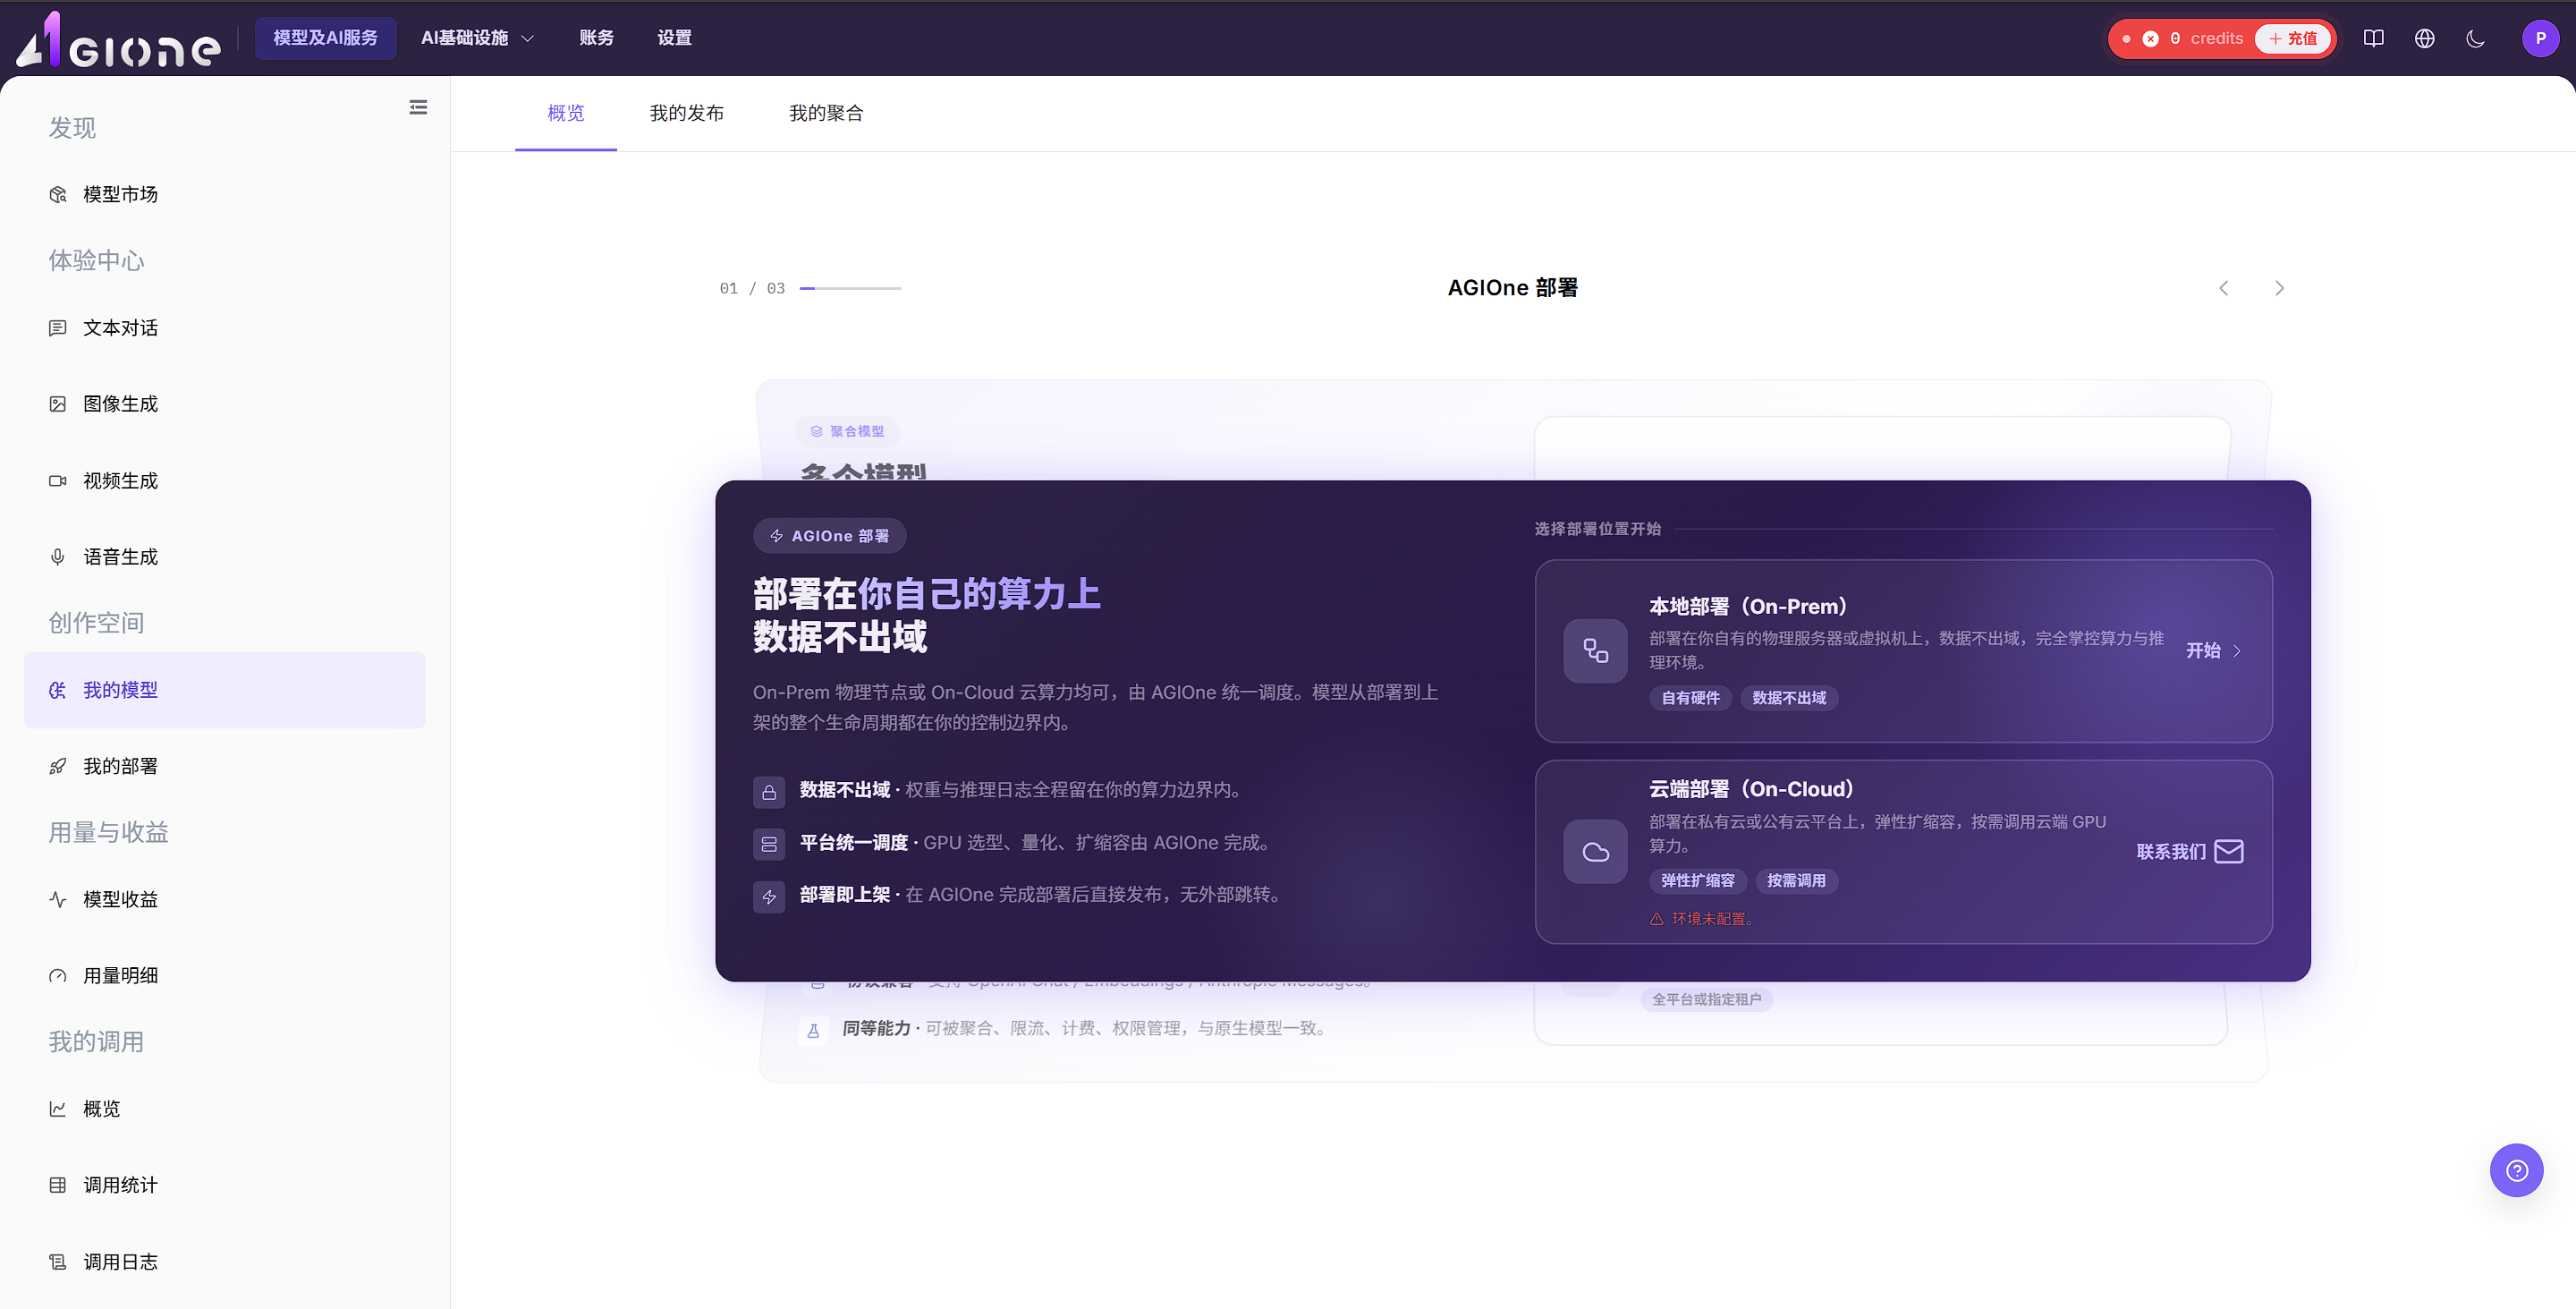
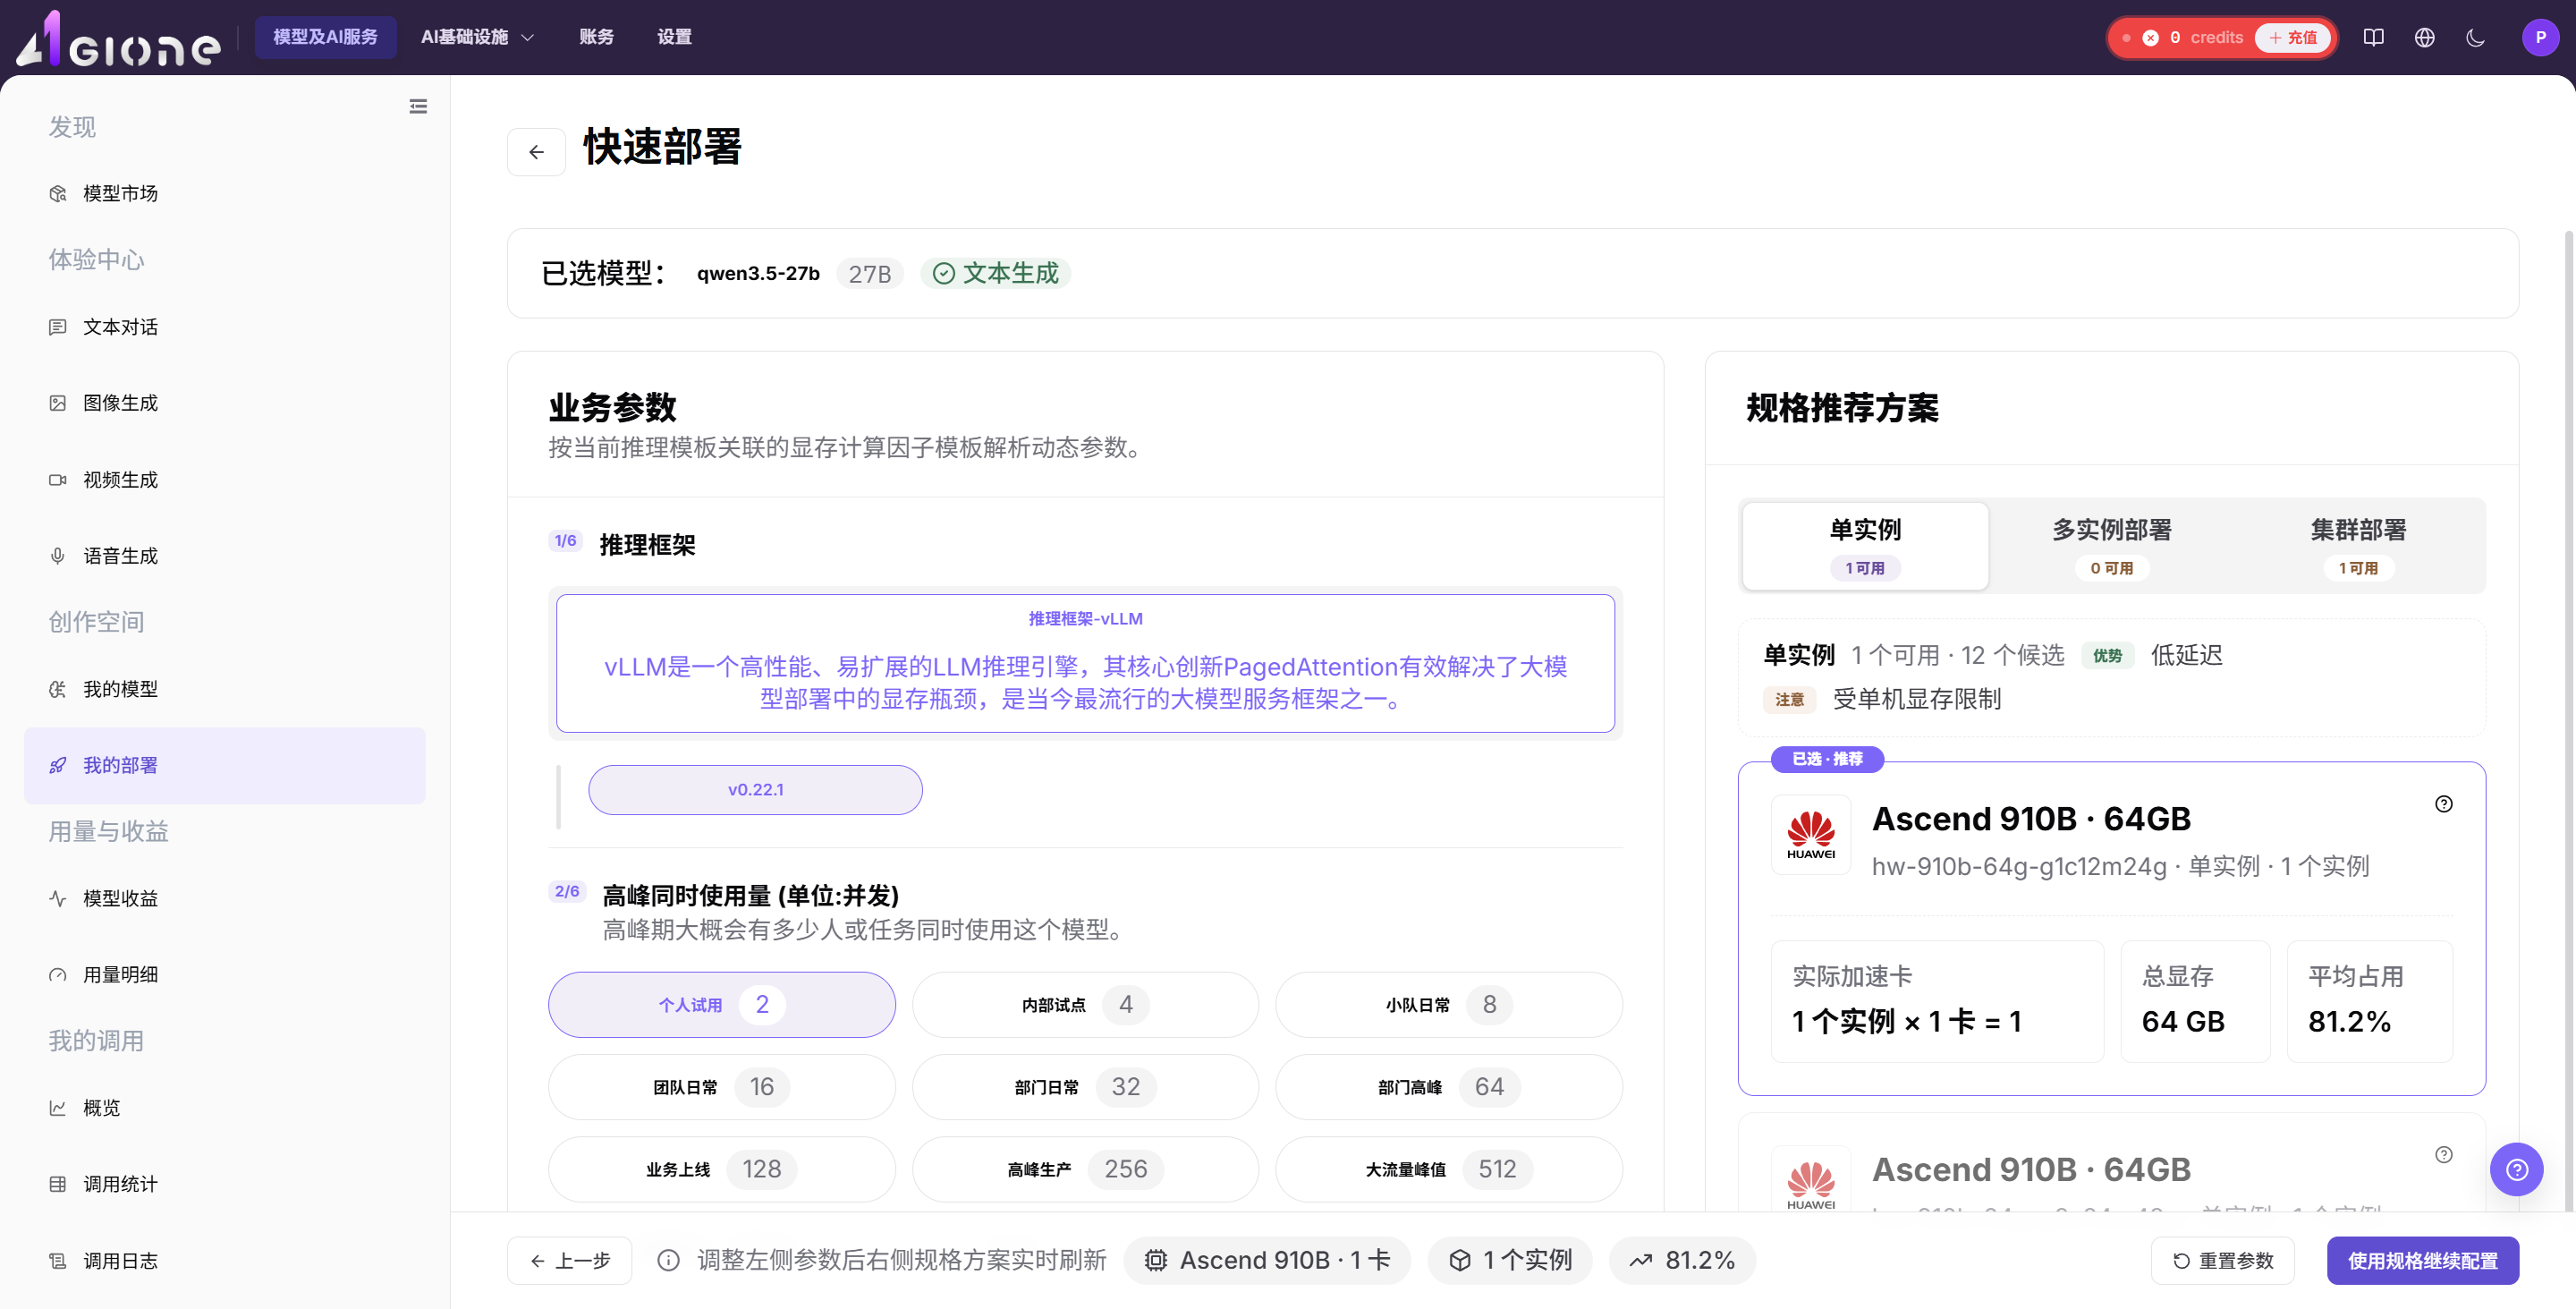
搜索要部署的模型并进入配置页面。设置此模型实例的并发数和上下文长度,右侧会自动更新可支持的规格,选择推荐的规格。
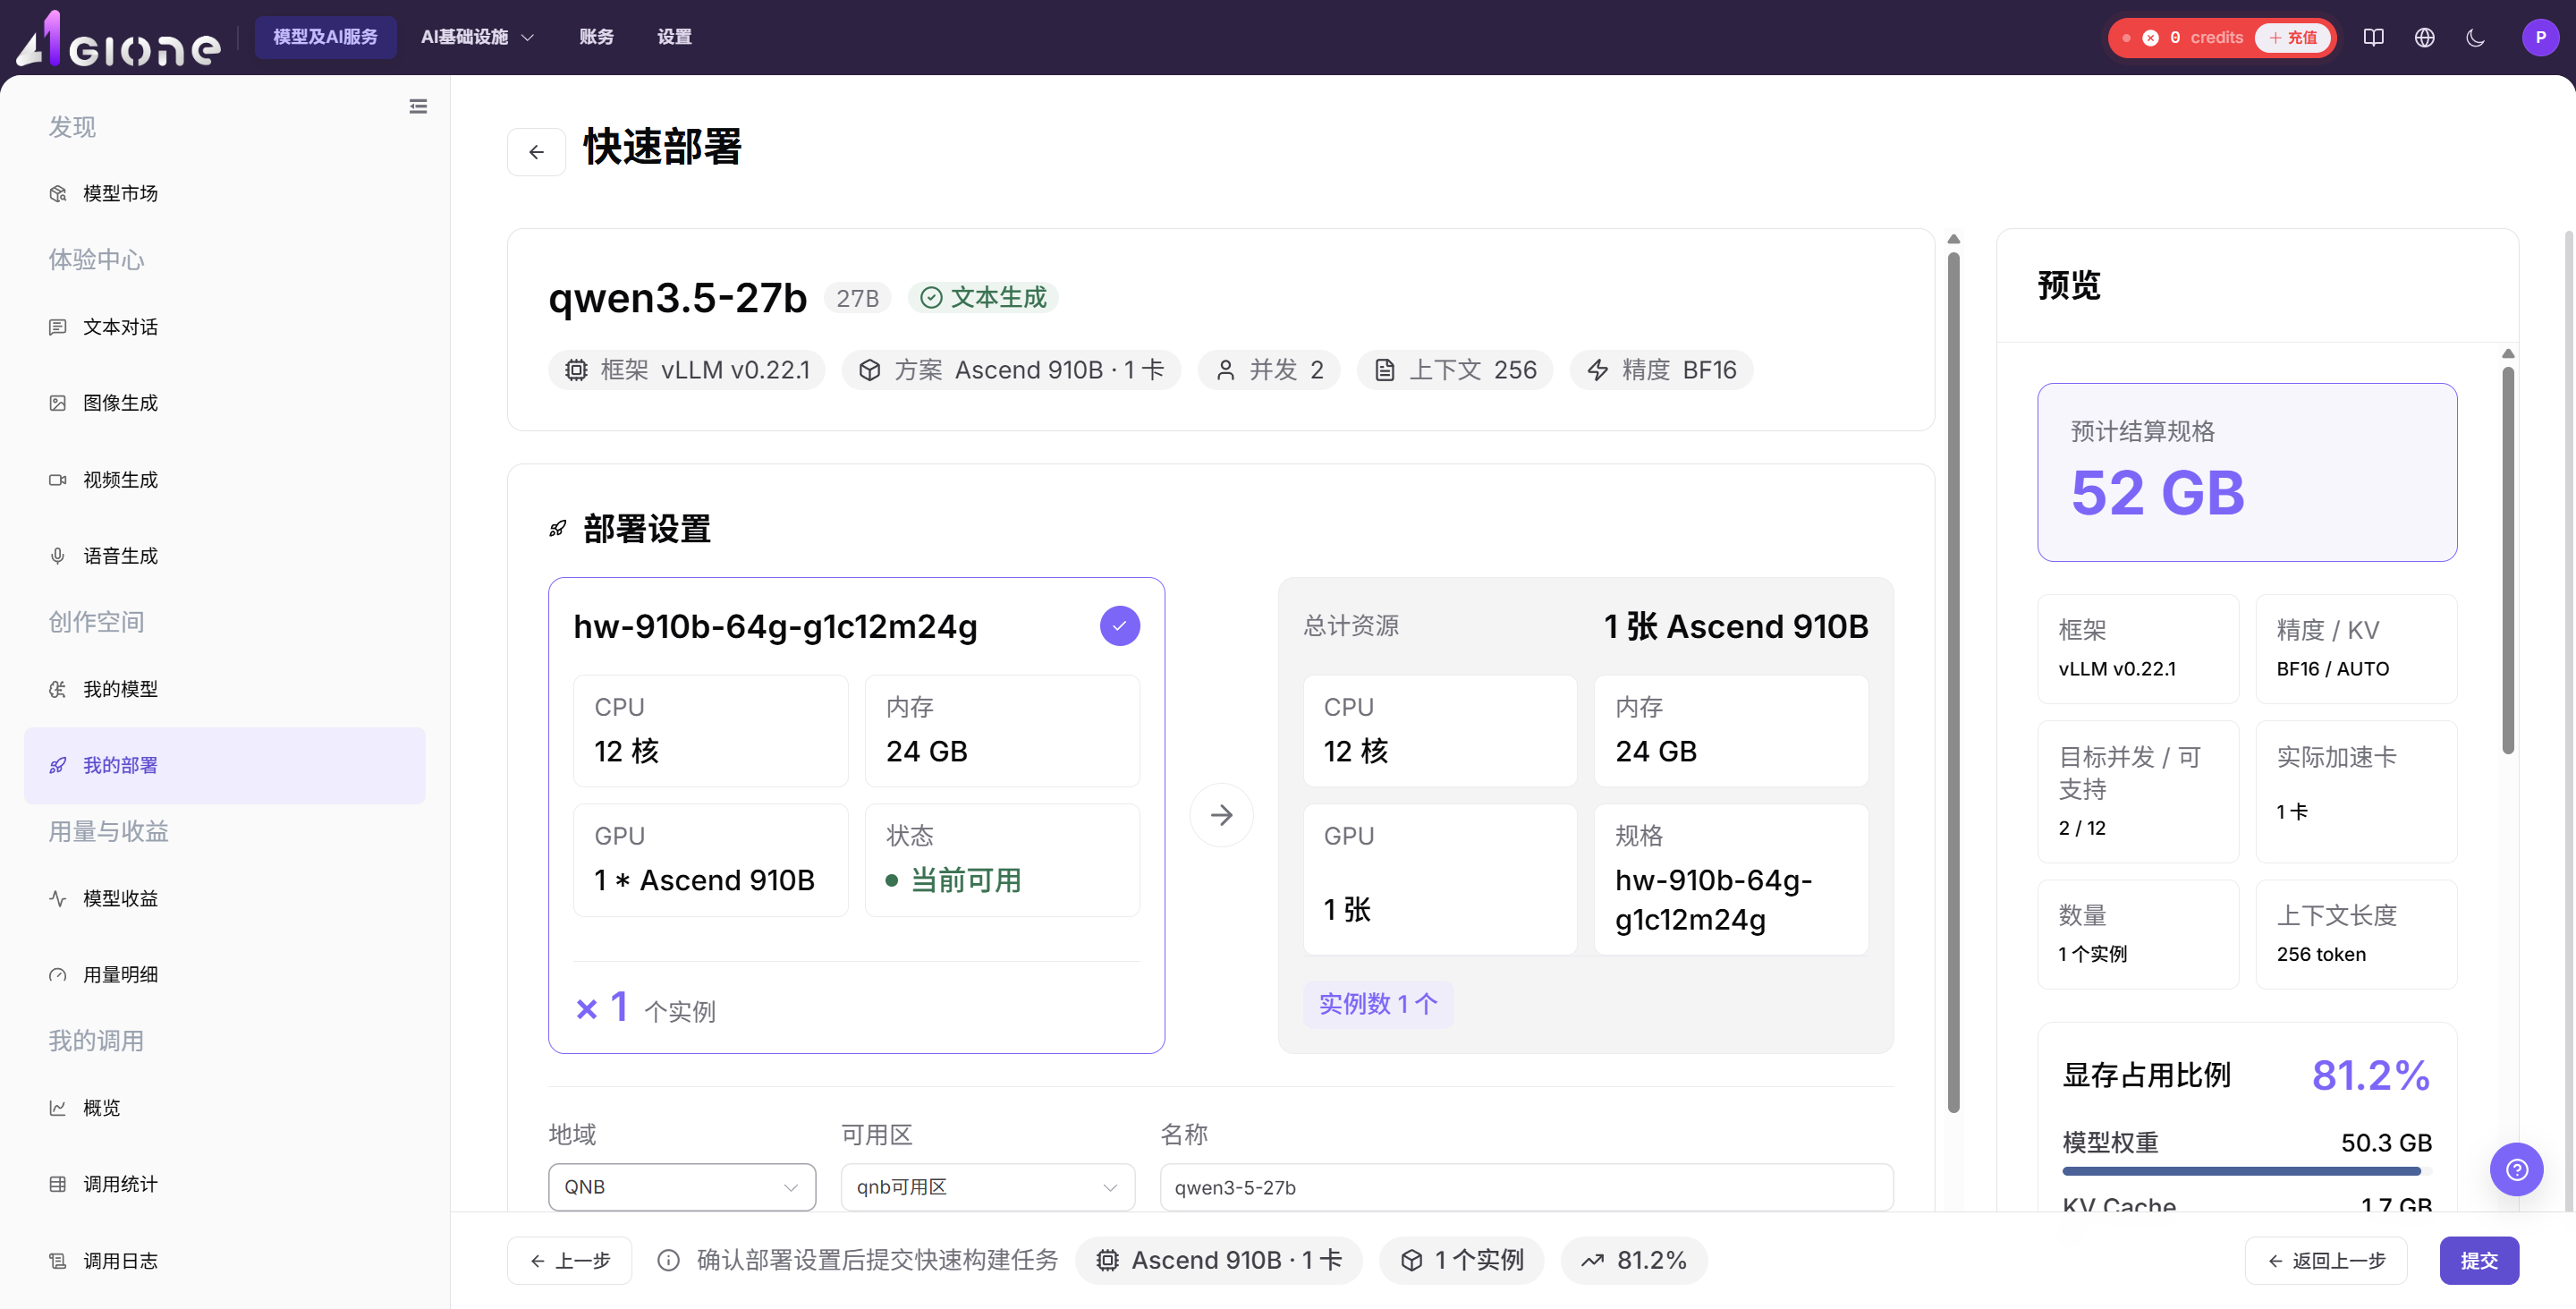
确认配置无误后,点击 Submit 提交部署。
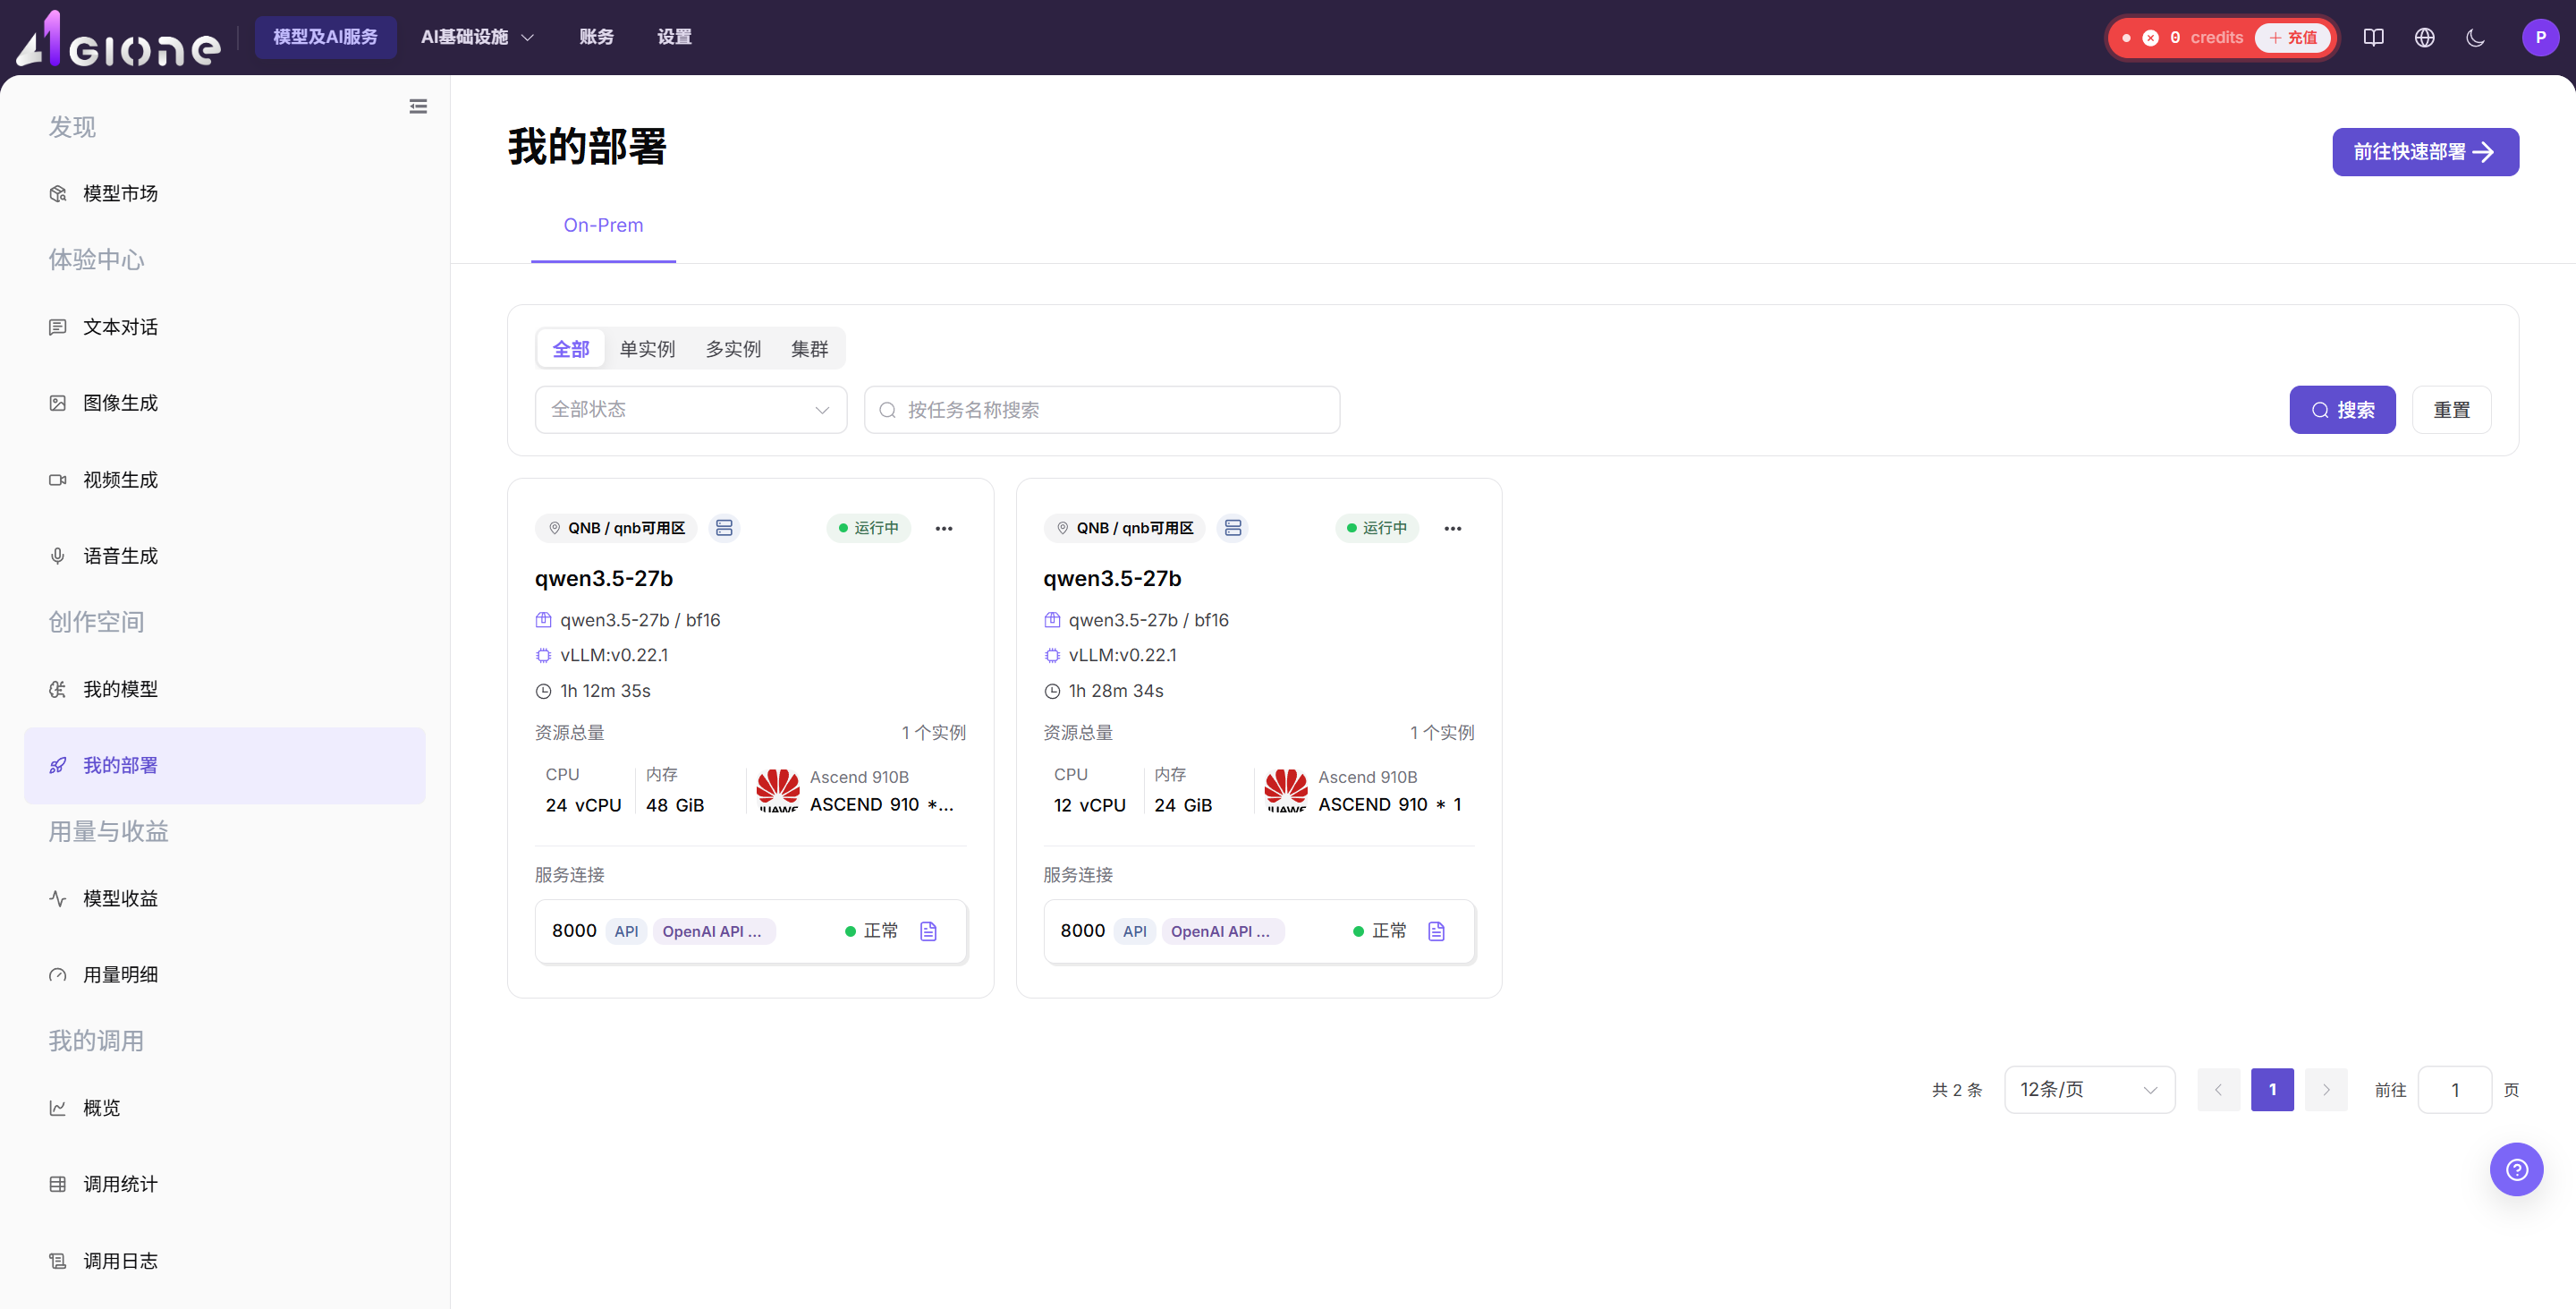
提交后模型实例进入启动流程。可以点击 Search 刷新模型实例状态。等待模型变为 Running 状态且服务端口可用。此过程可能需要几分钟。
2. 使用已创建的实例发布模型(模型提供方)
模型实例状态变为可用后,点击 Publish 开始发布模型。
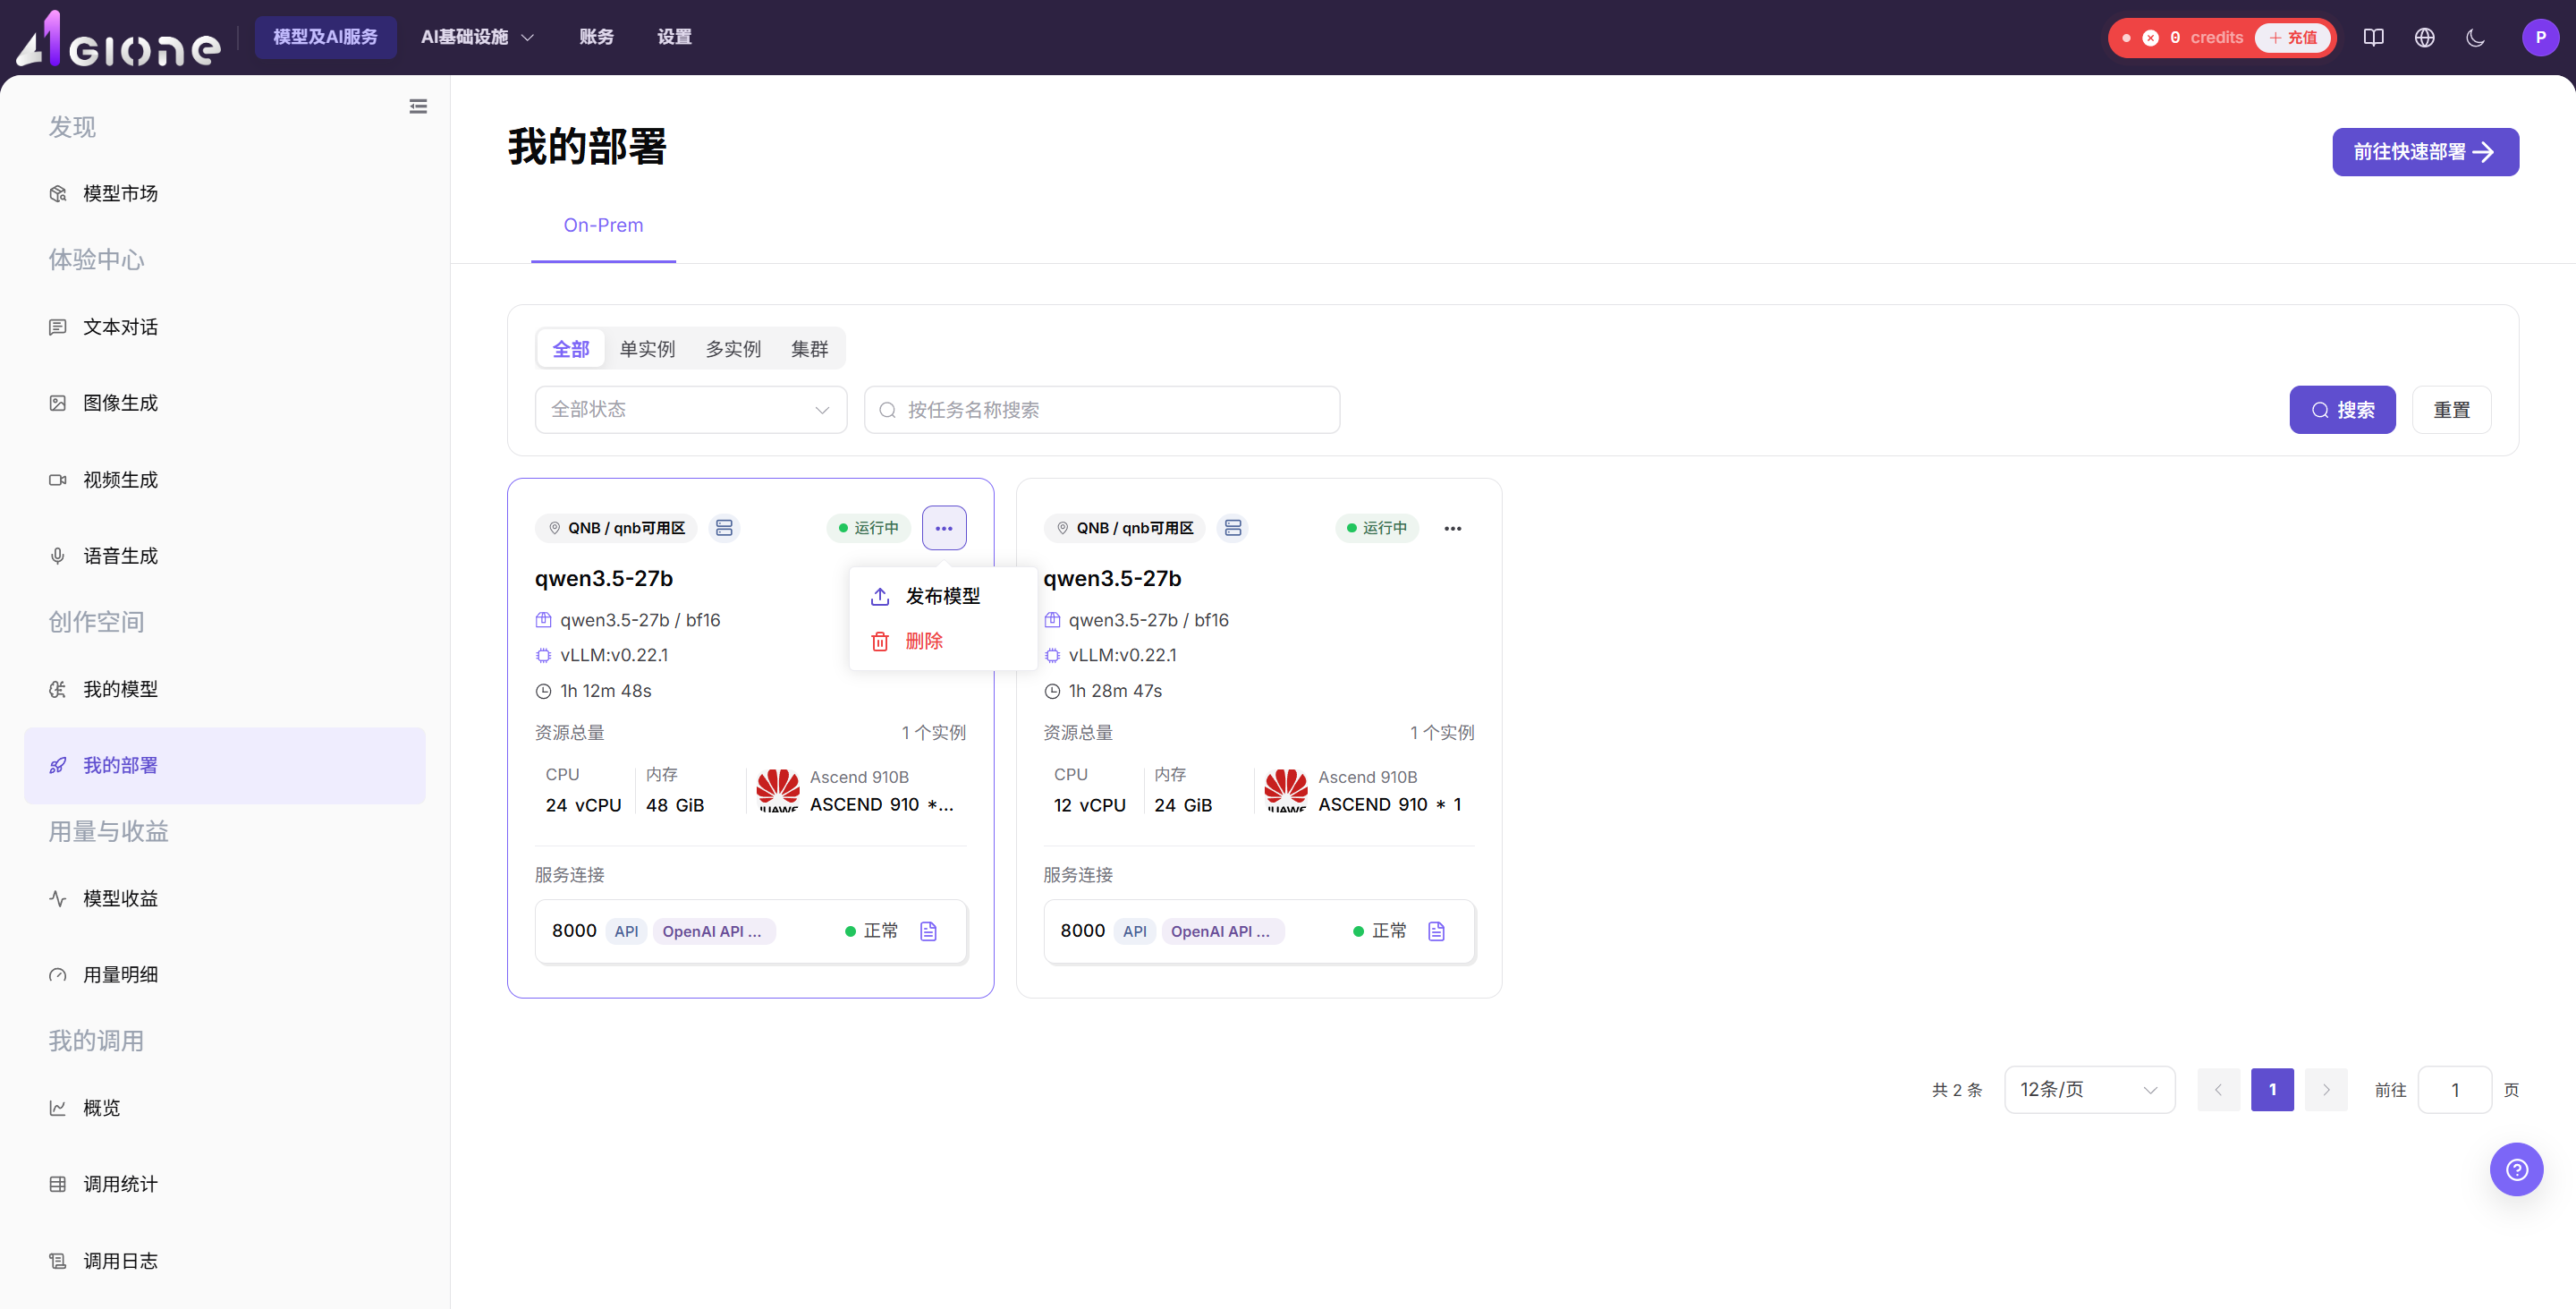
选择已批准的 Public 或 Private 范围进入发布页面。至少启用一种 API 协议(例如 OpenAI-ChatCompletions),然后点击 Test 确认模型连通性可用。
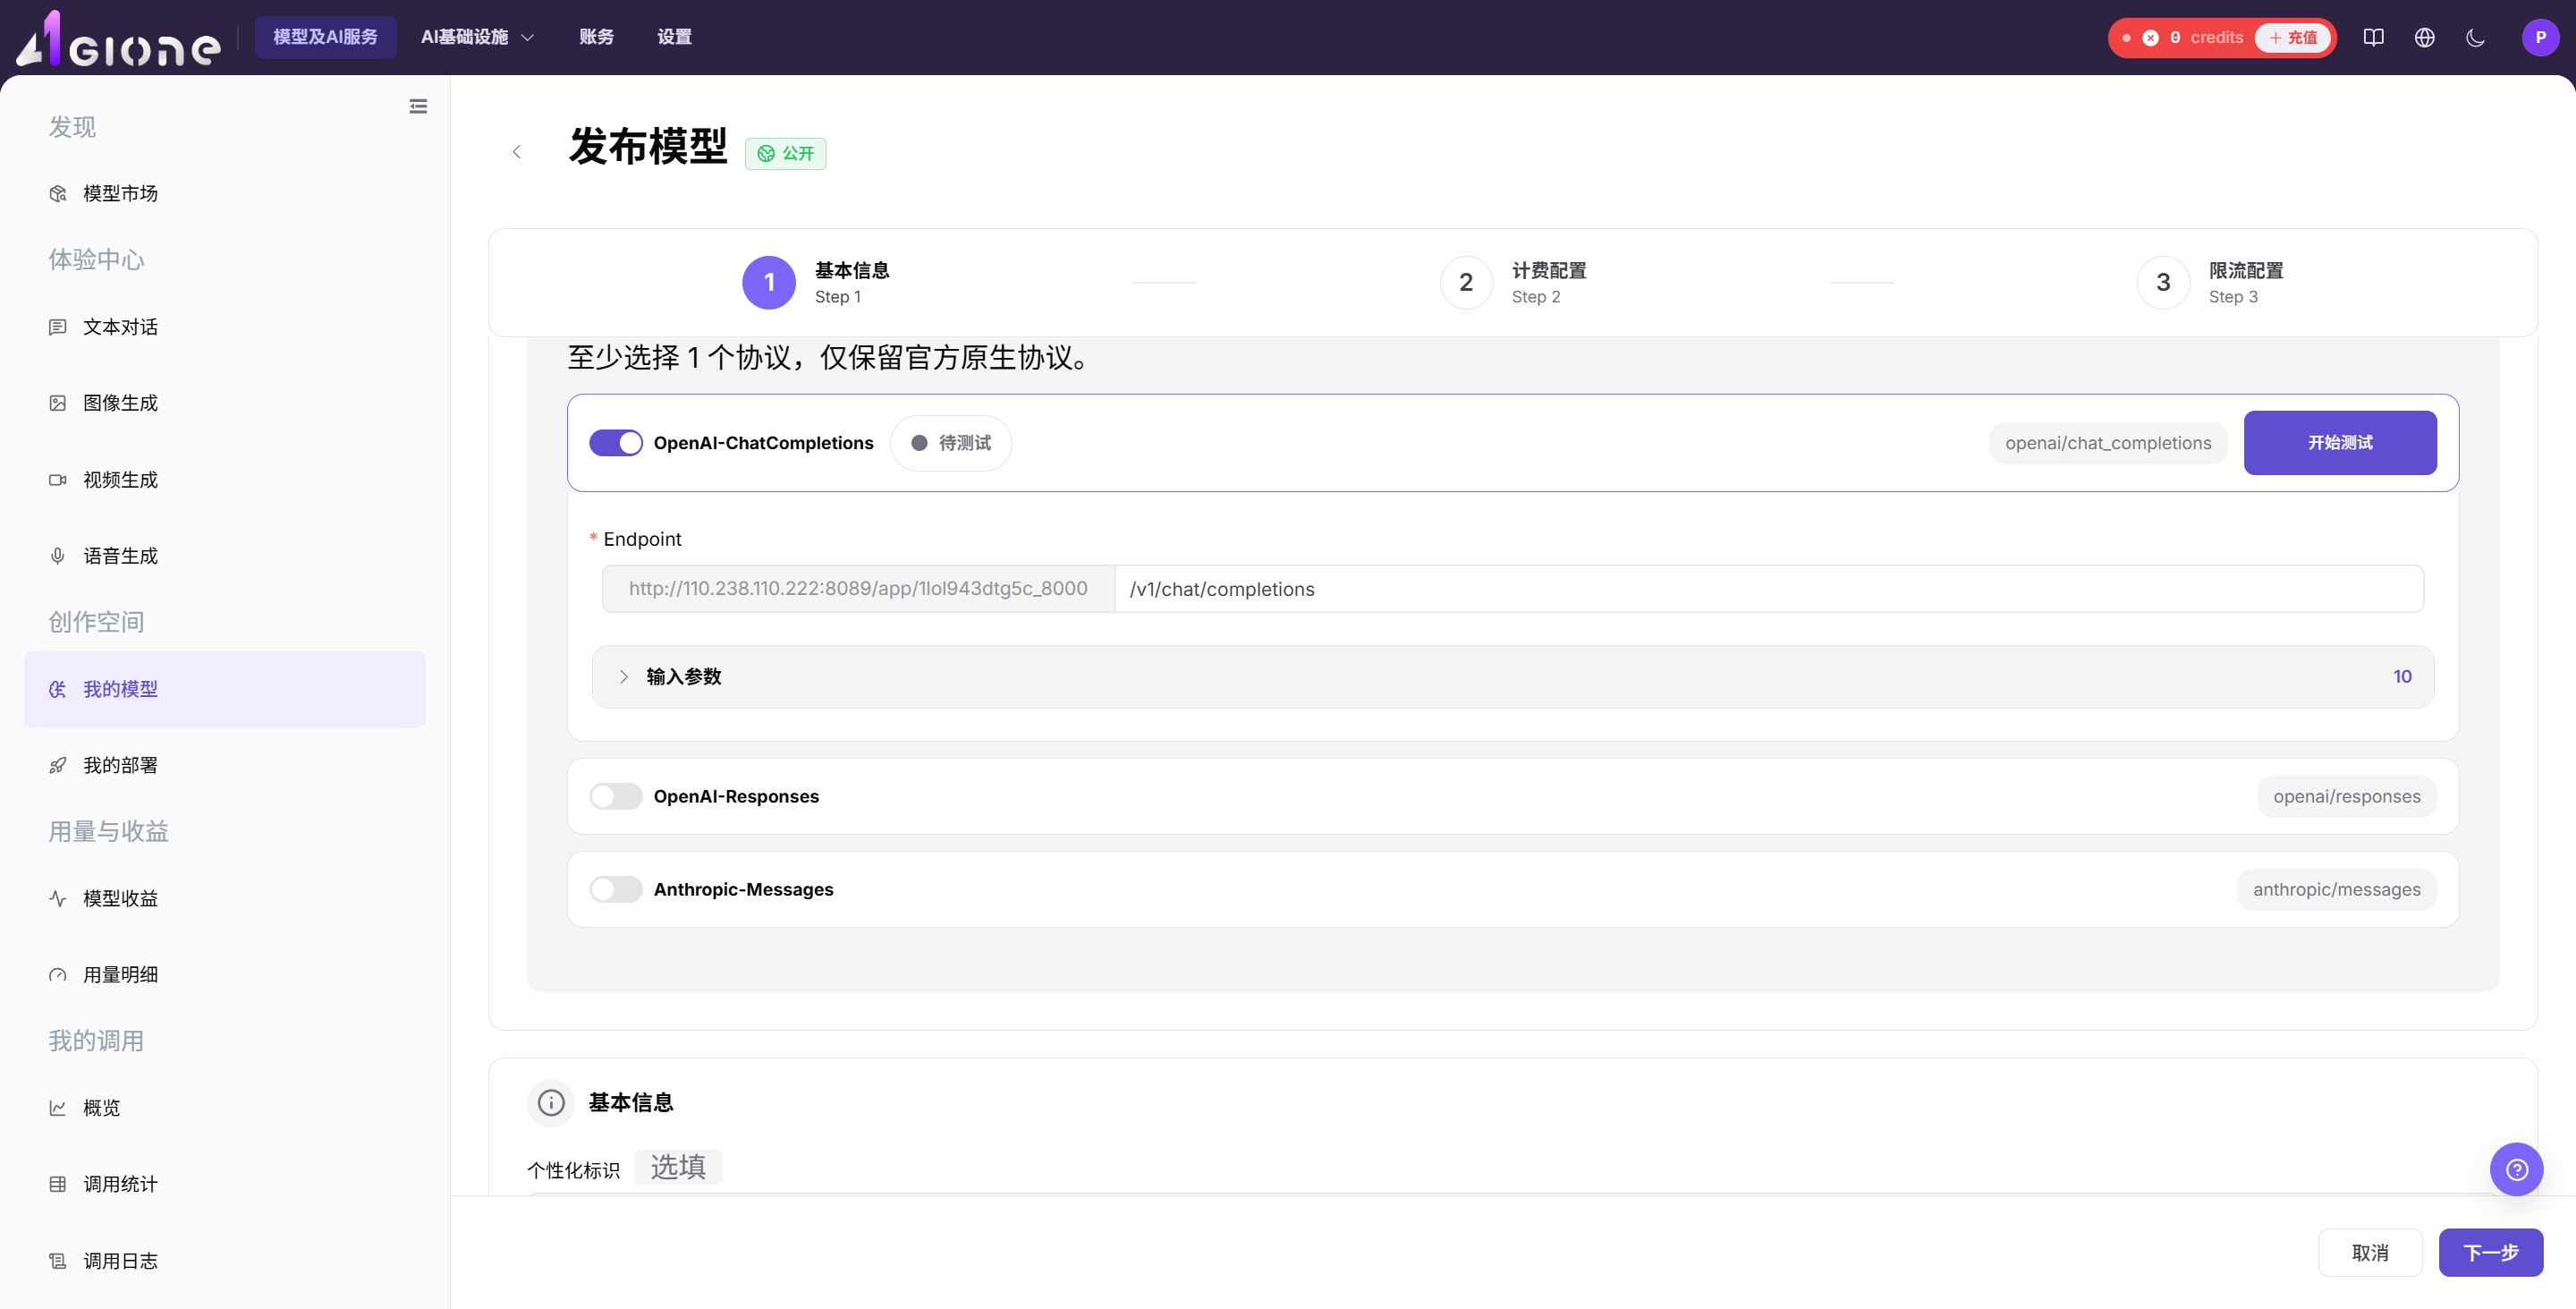
还可以根据环境要求将 Custom Tag 设置为测试标签(如 testing)。
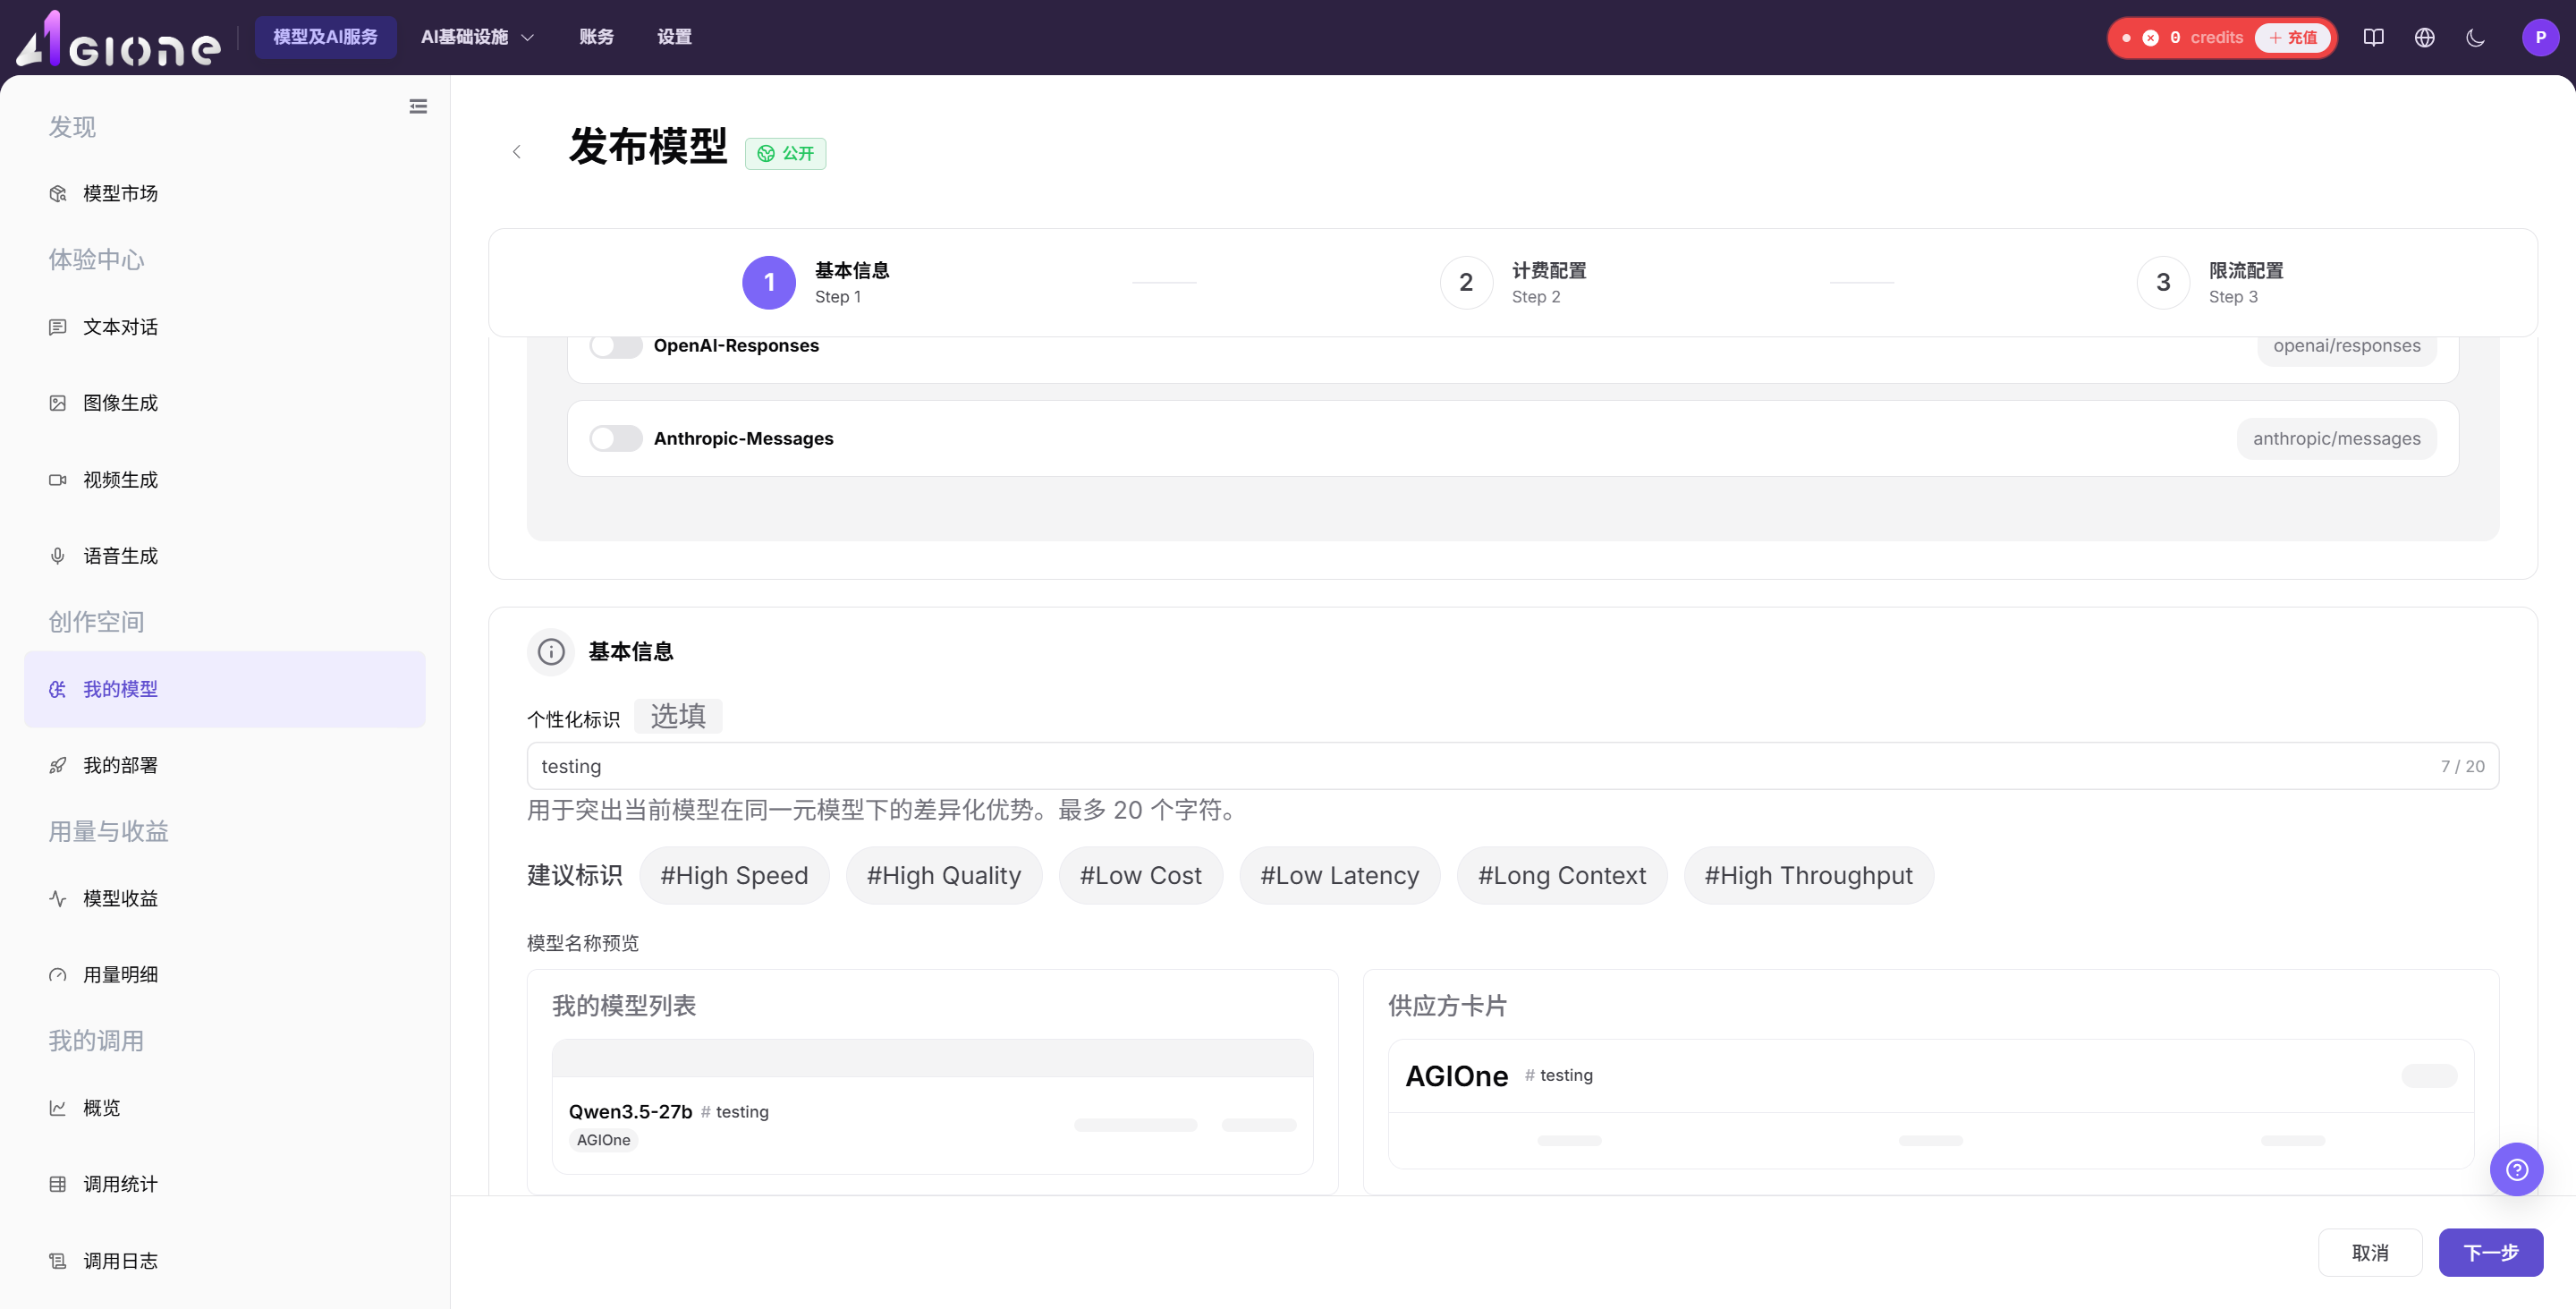
下一步配置计费选项。受控测试场景下可设置为 Free(免费)。
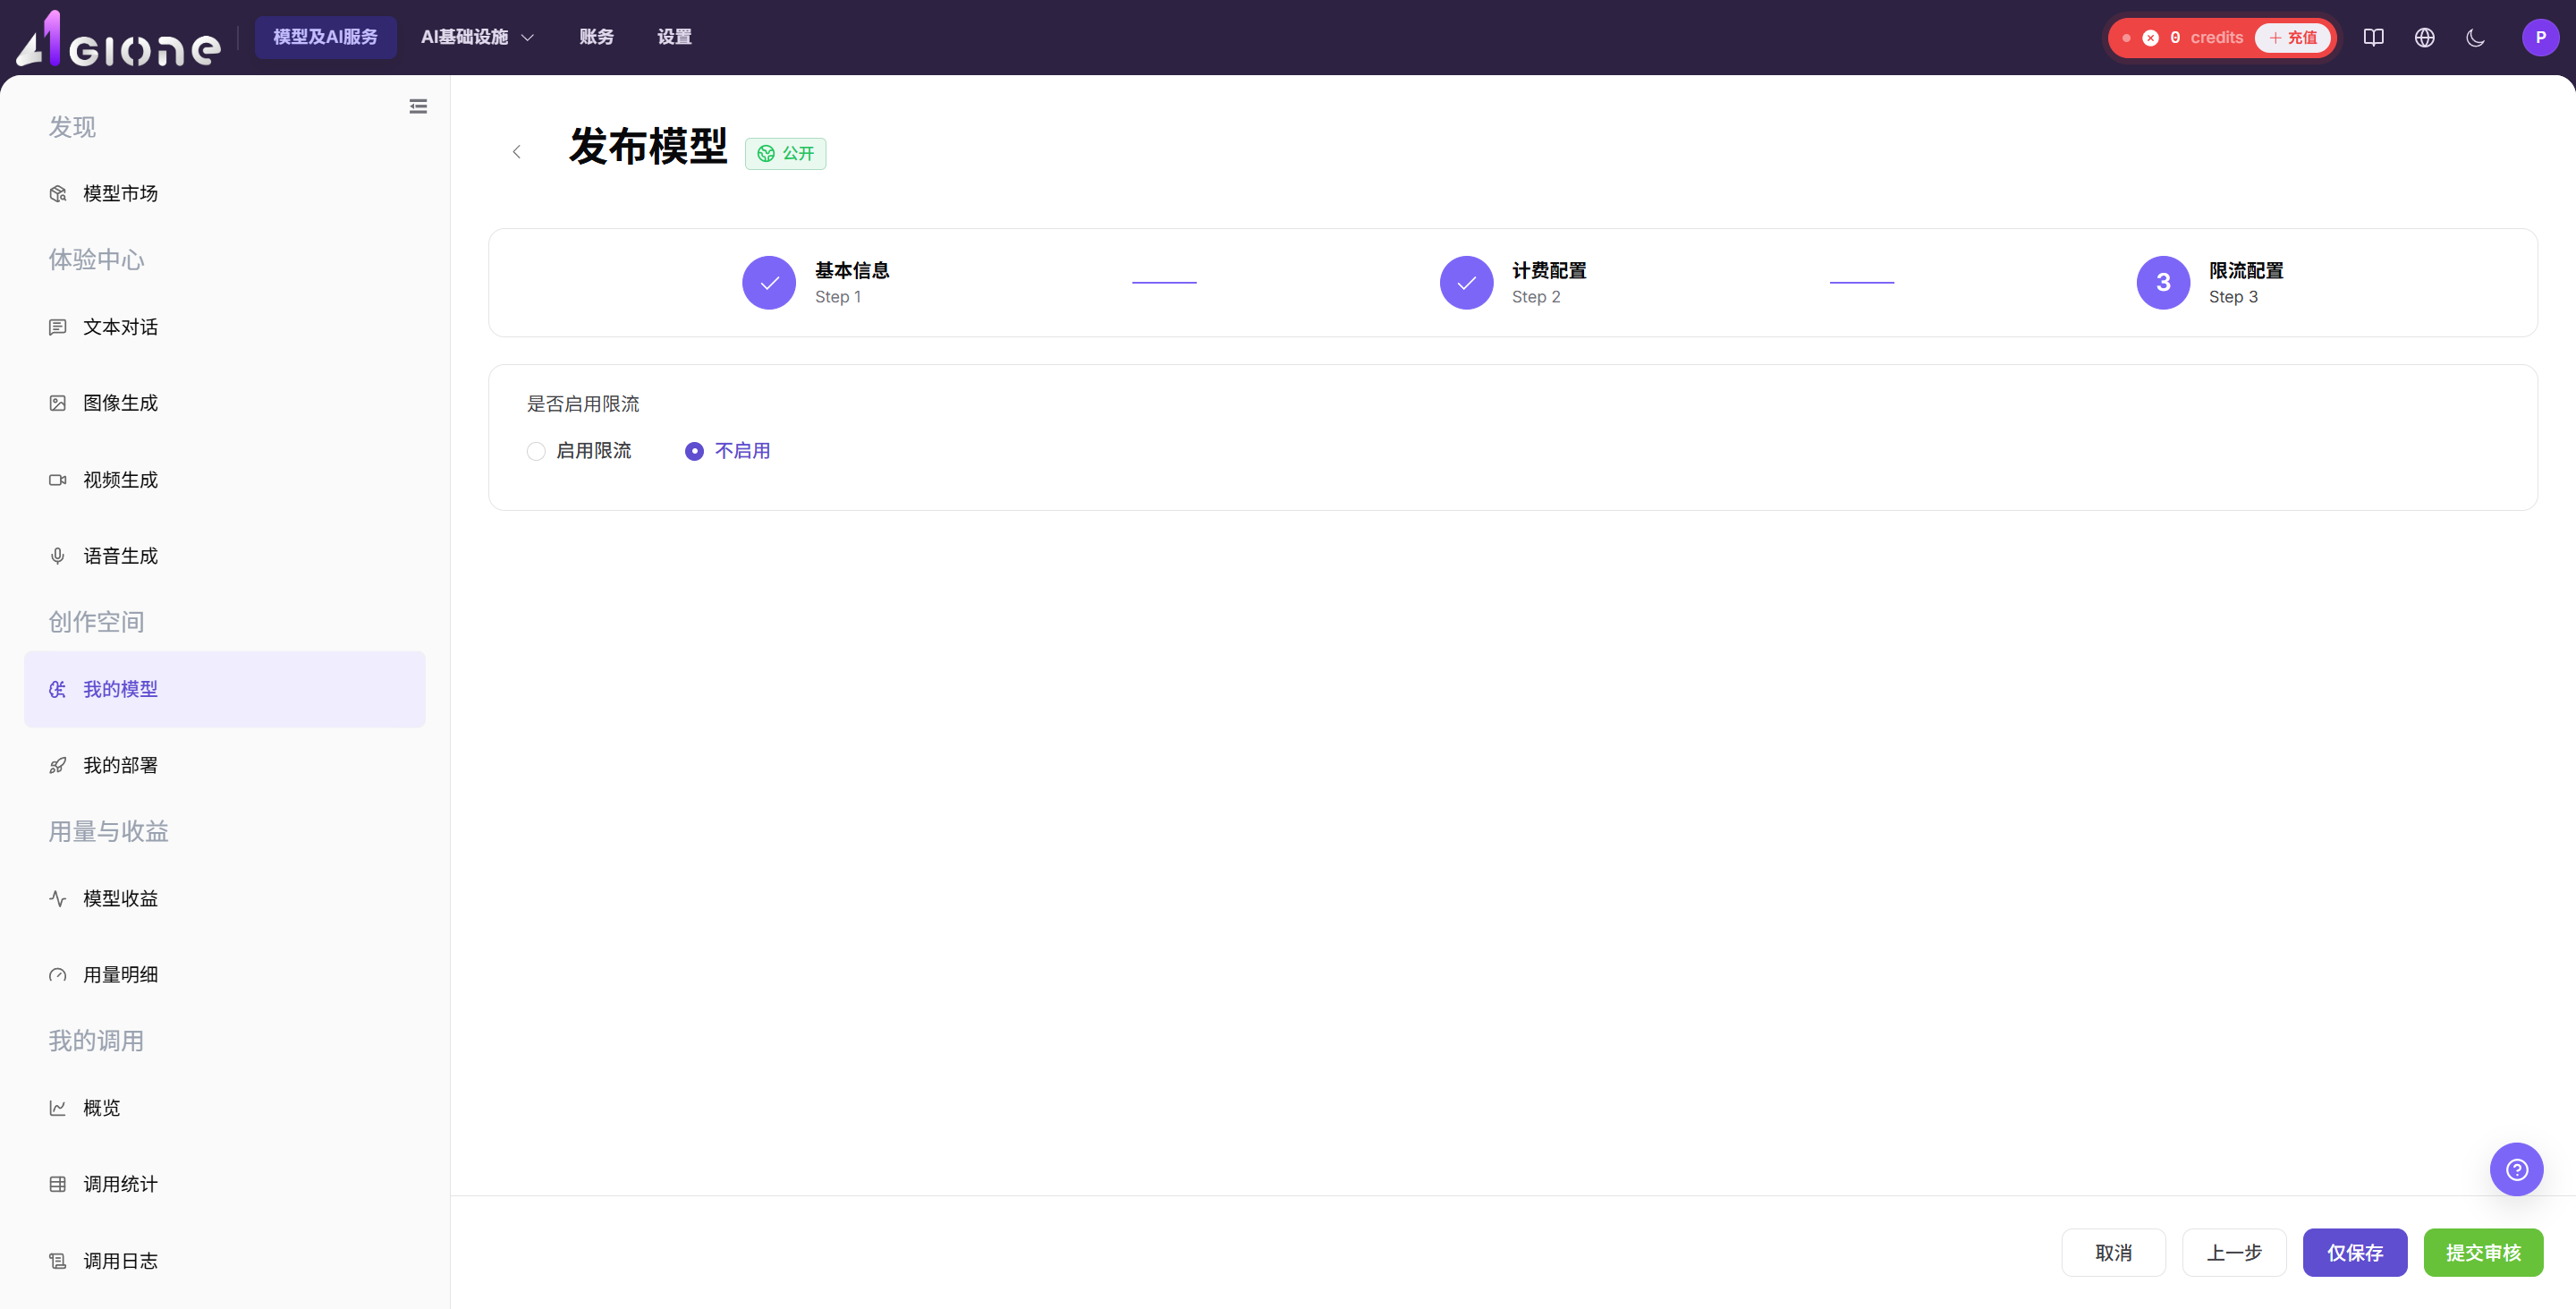
进入 Rate Limit 页面。受控测试只有在当前环境策略允许时才可以不启用限流。页面要求审批时提交审批;如果不需要审批,则直接核对发布后的状态。
3. 调用模型进行测试(模型提供方)
点击进入 模型服务 > 发现 > 模型 (Models),搜索已发布的模型。
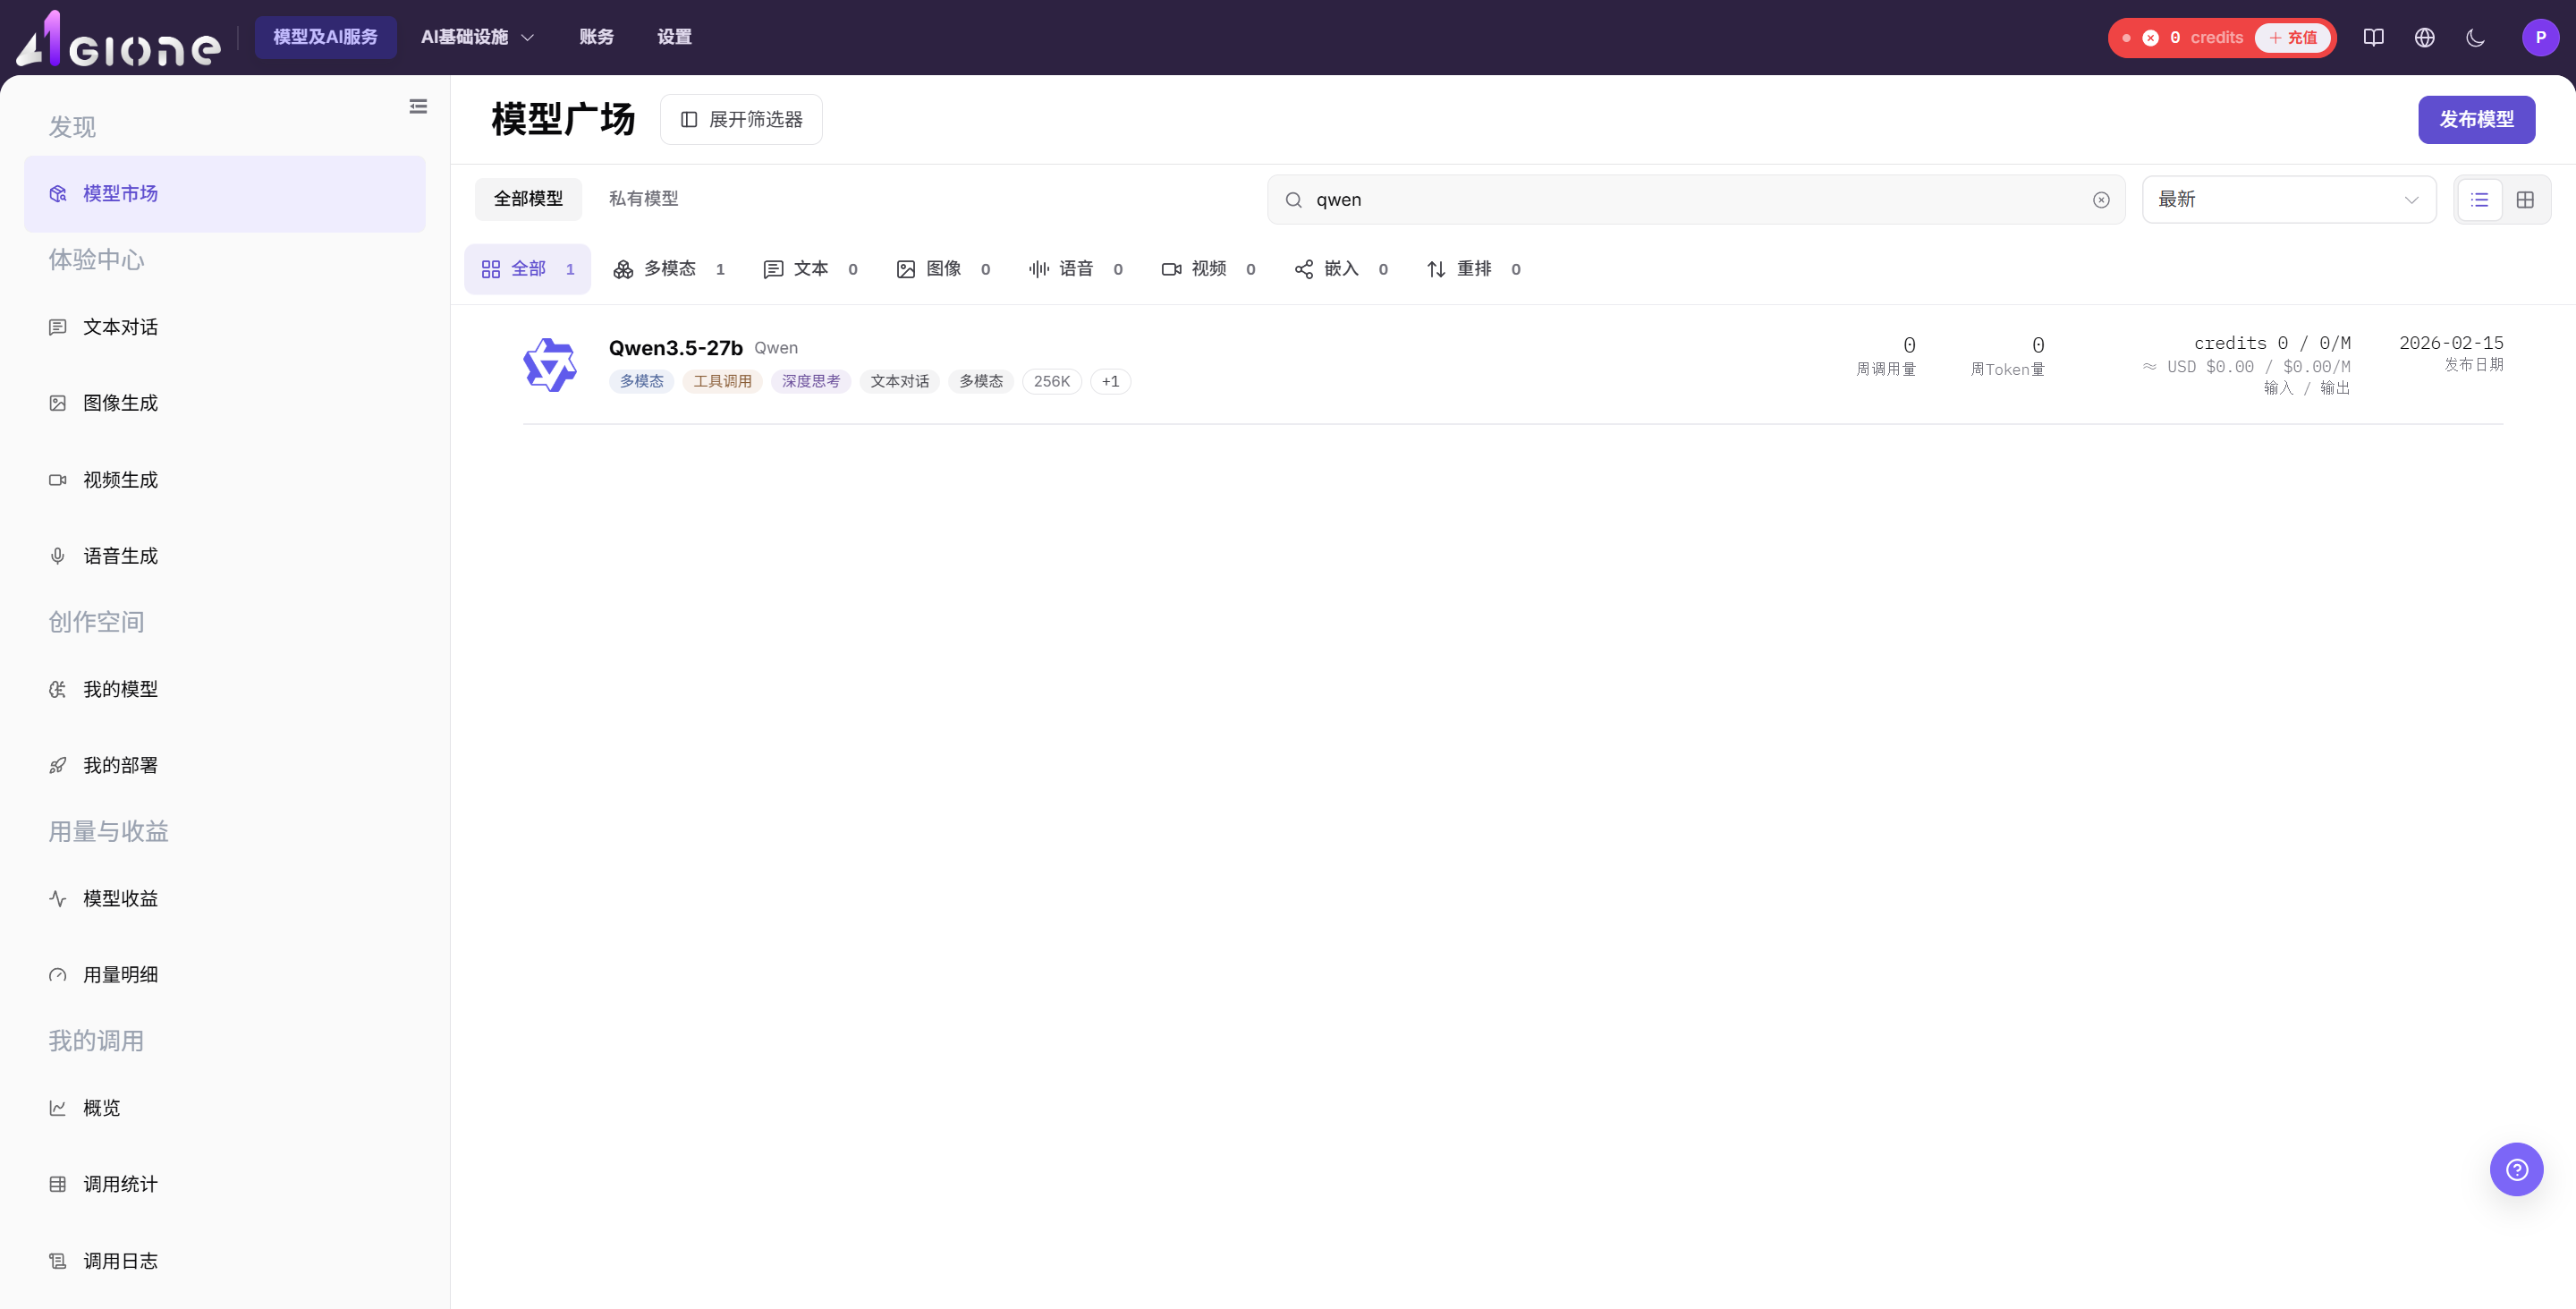
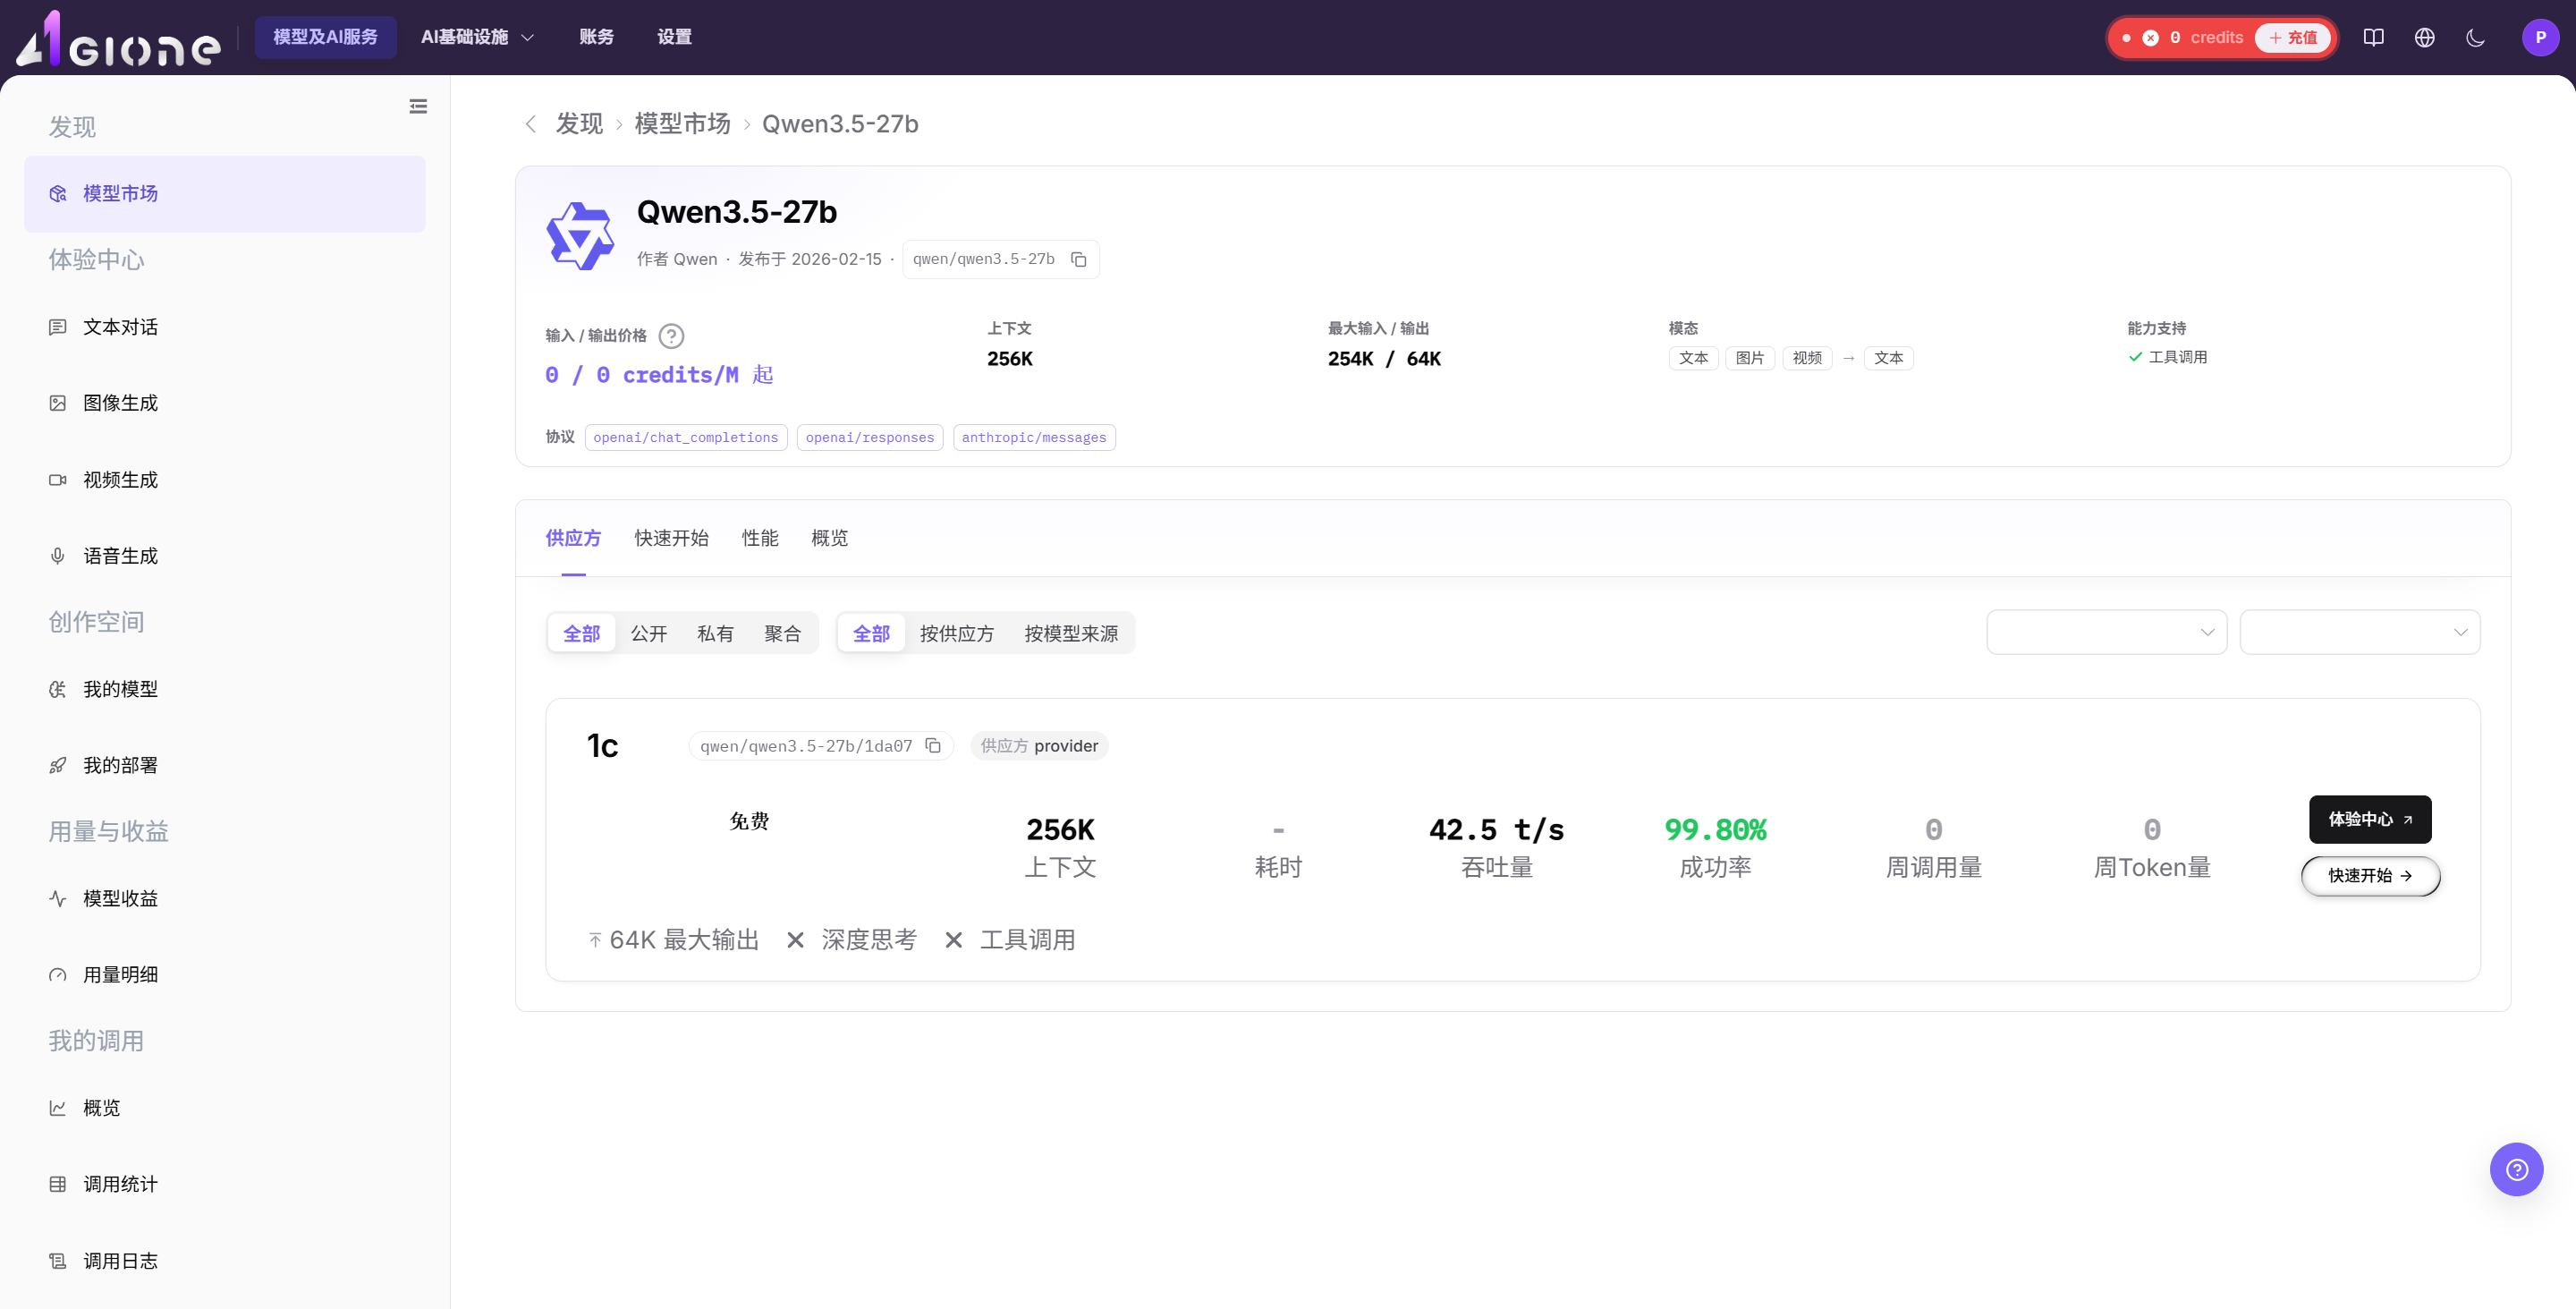
找到在模型提供方页面发布的模型,点击 Playground,在新的浏览器标签页中打开在线 Chat 界面。
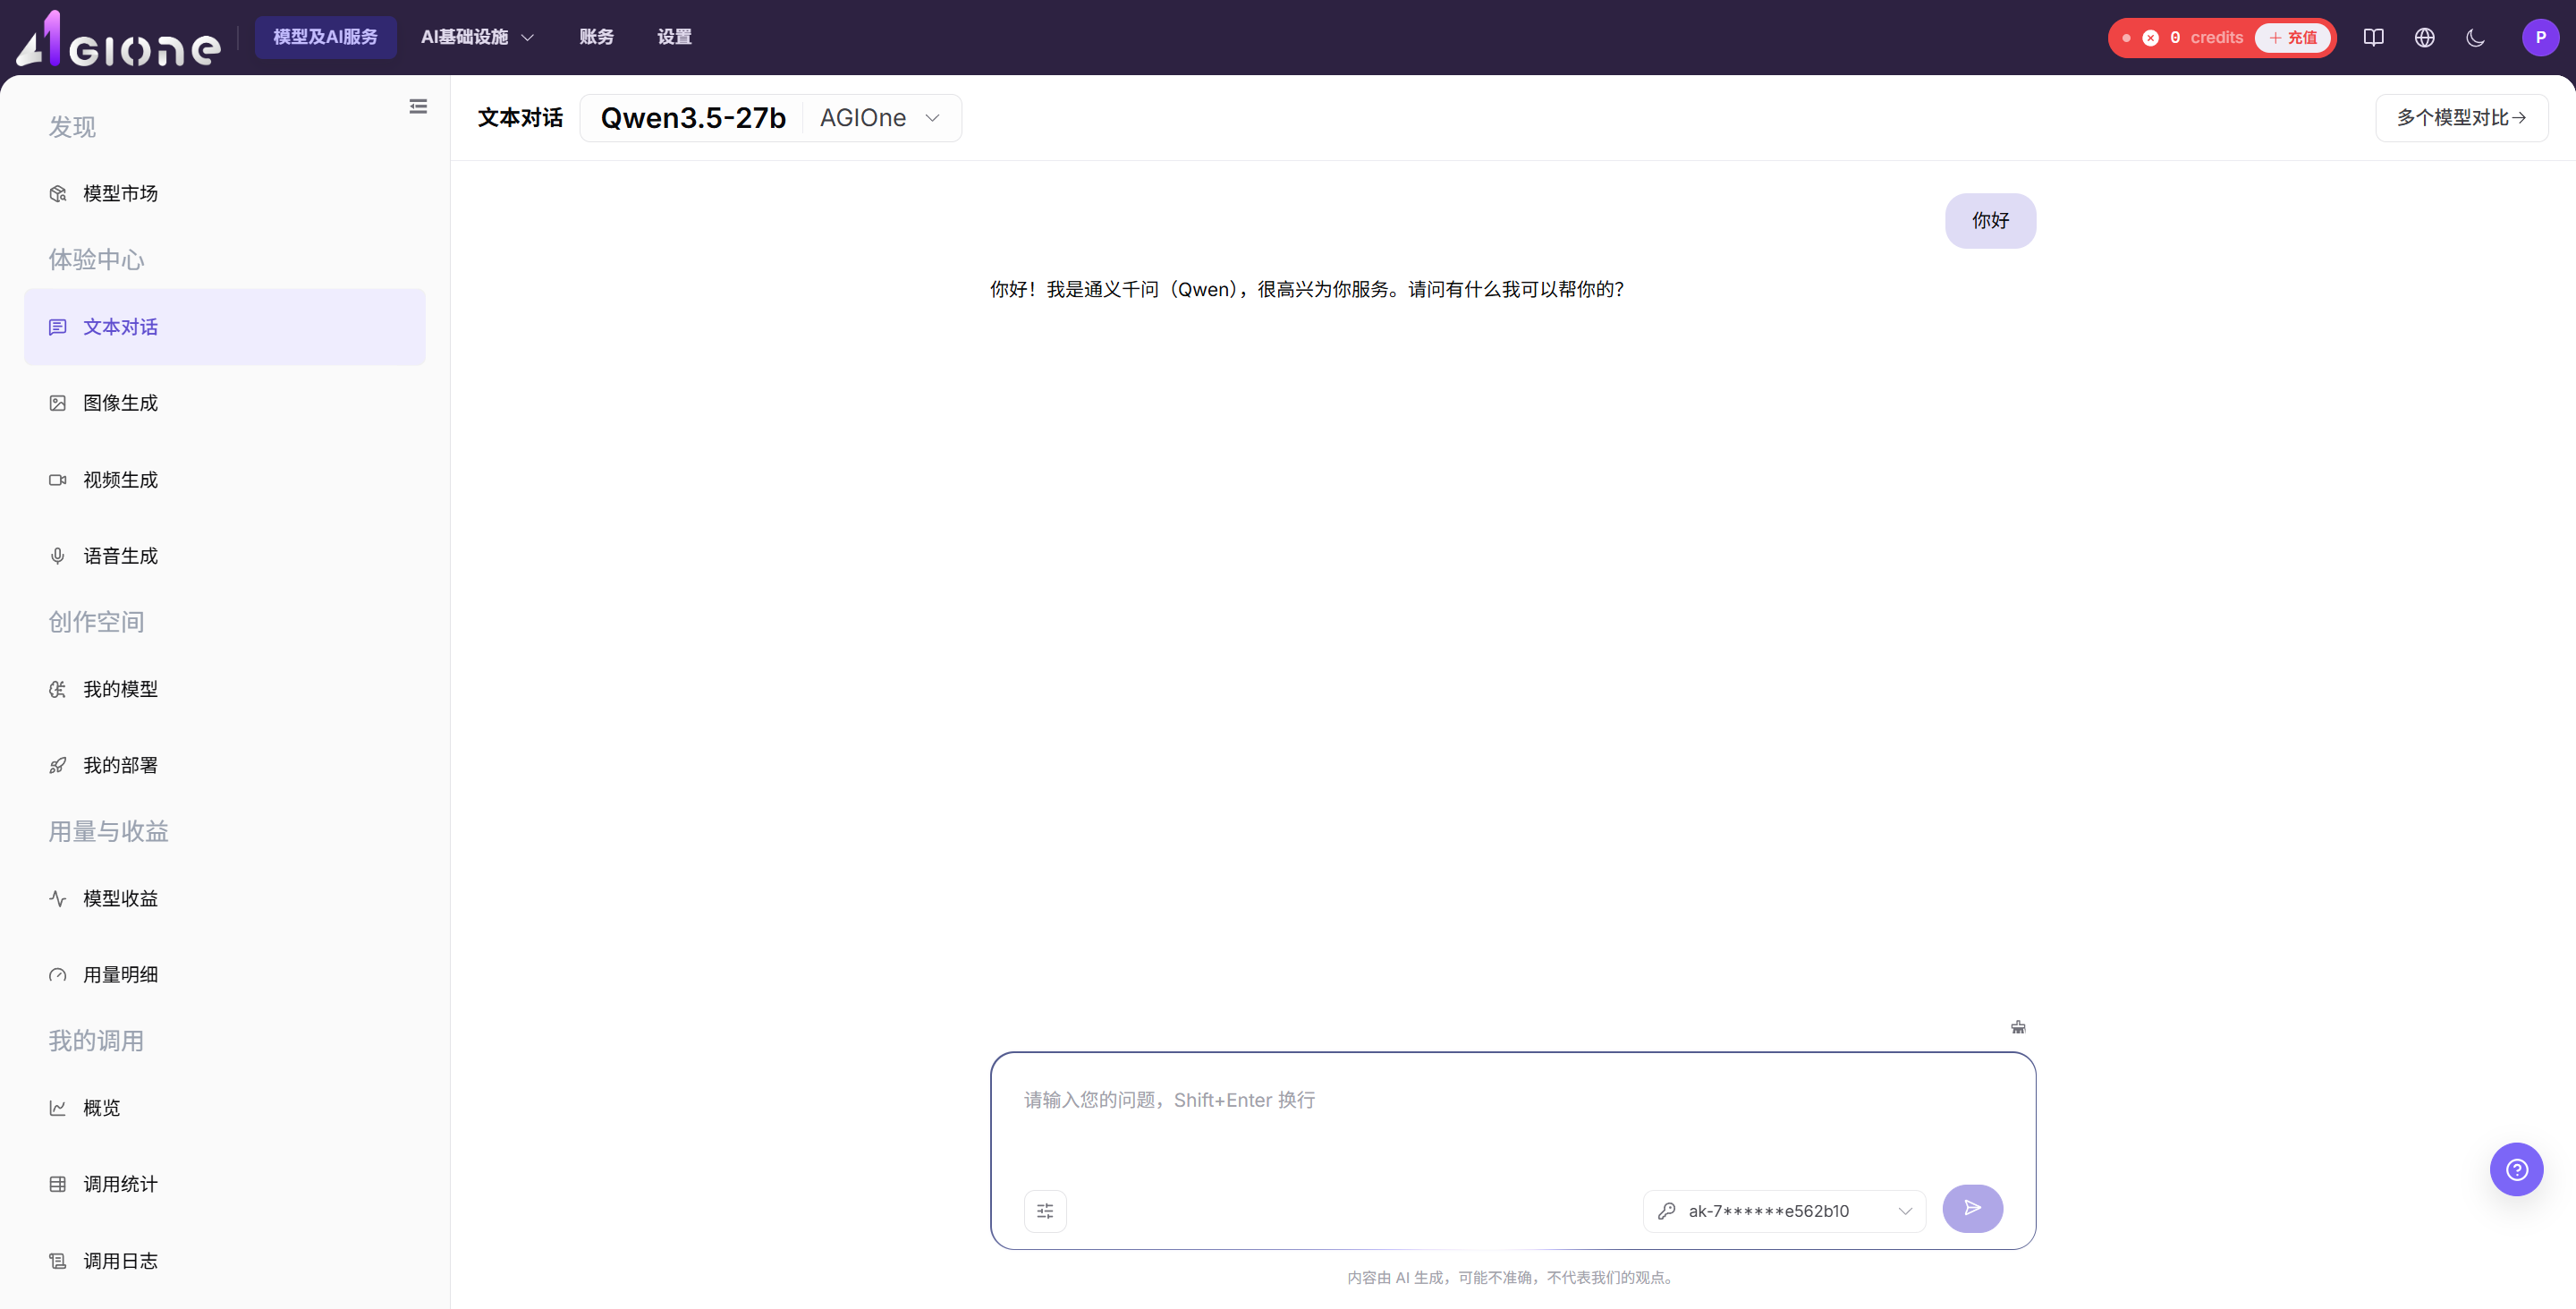
在对话框中输入提示词,验证模型输出流式响应。
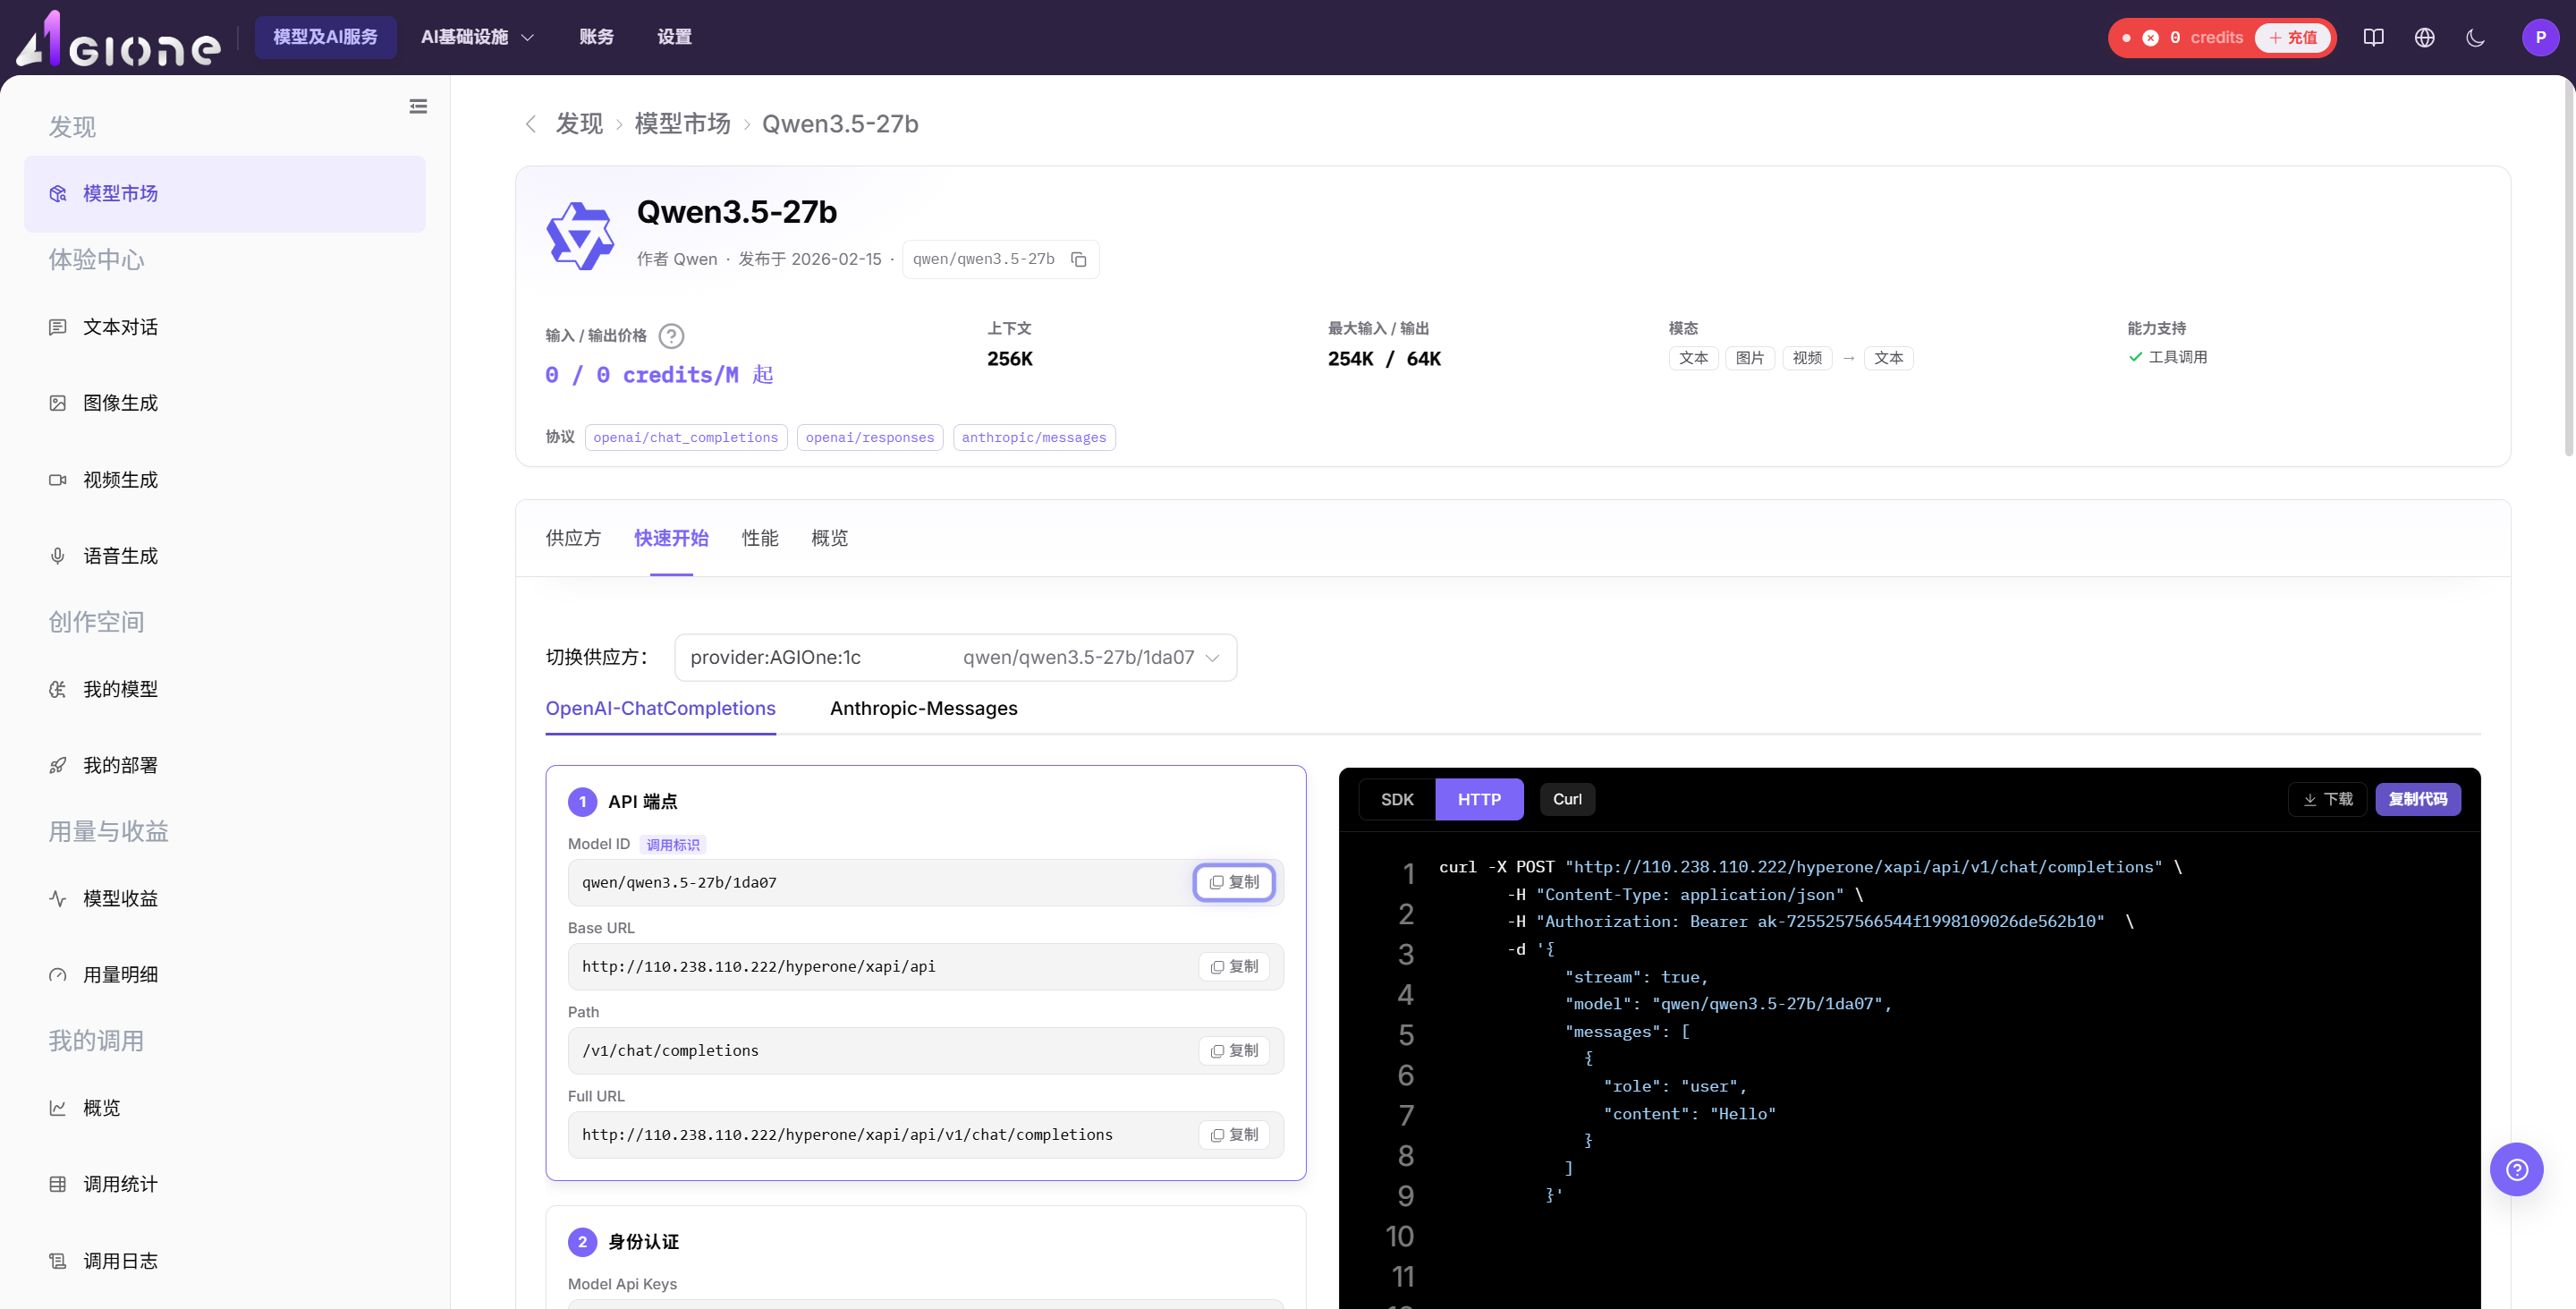
也可以使用 cURL 命令行进行接口测试,点击 Quick start 查看详细接入信息。
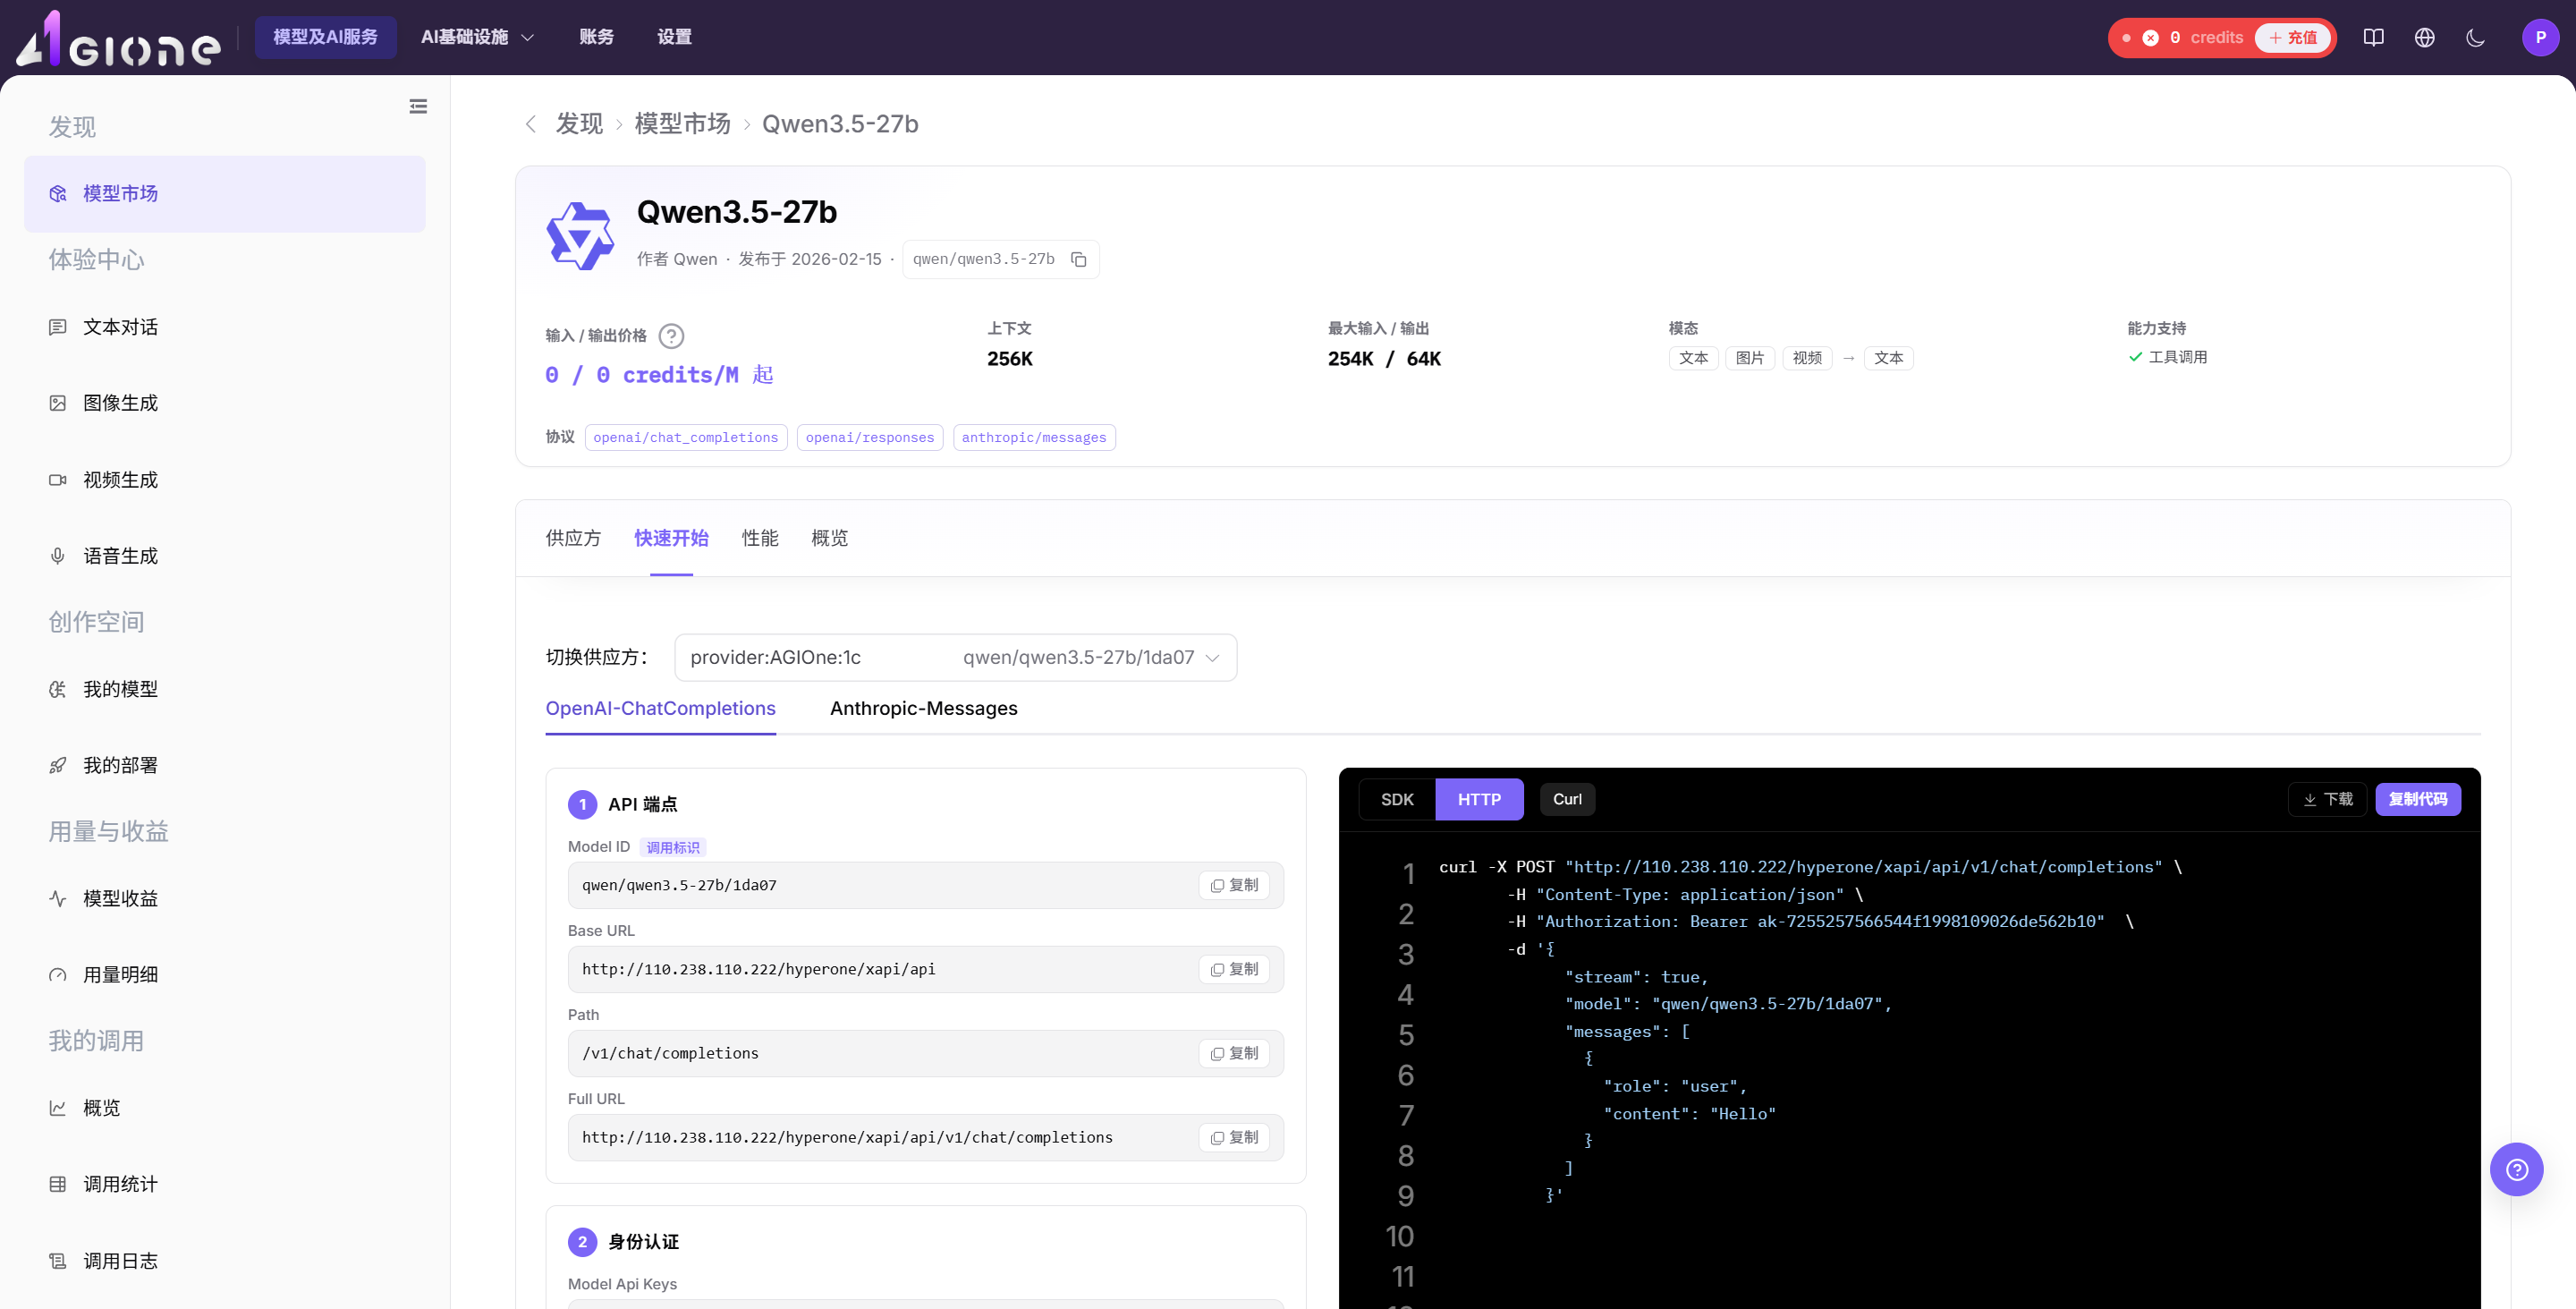
复制预生成的 cURL 示例命令。
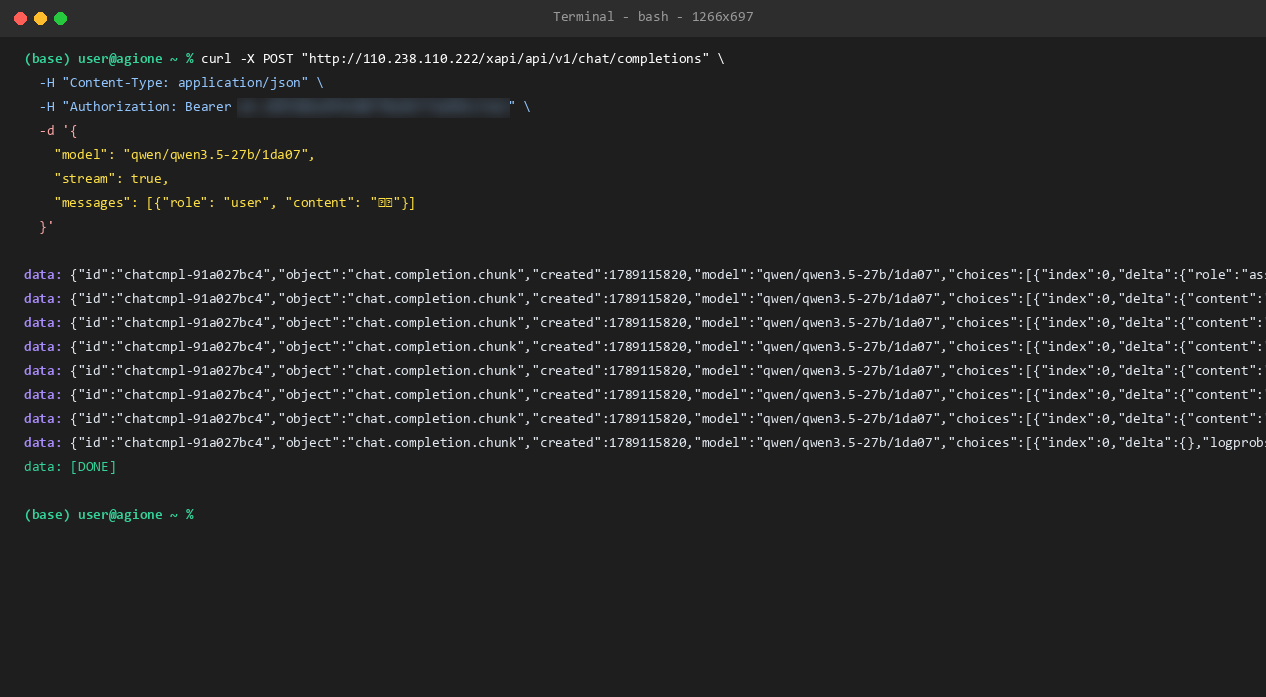
将命令粘贴到终端环境执行,验证模型生成的文本输出。
场景 B:准备新的模型模板(运营管理员)
1. 确保模型已下载(运营管理员)
使用运营管理员账号登录,从 AI-Infra > On-prem > 模板配置 > 模型管理 进入模型列表。搜索所需模型(例如 DeepSeek-R1-Distill-Qwen-7B)。如果列表中尚未创建该模型,可点击 Add Model 预先创建。
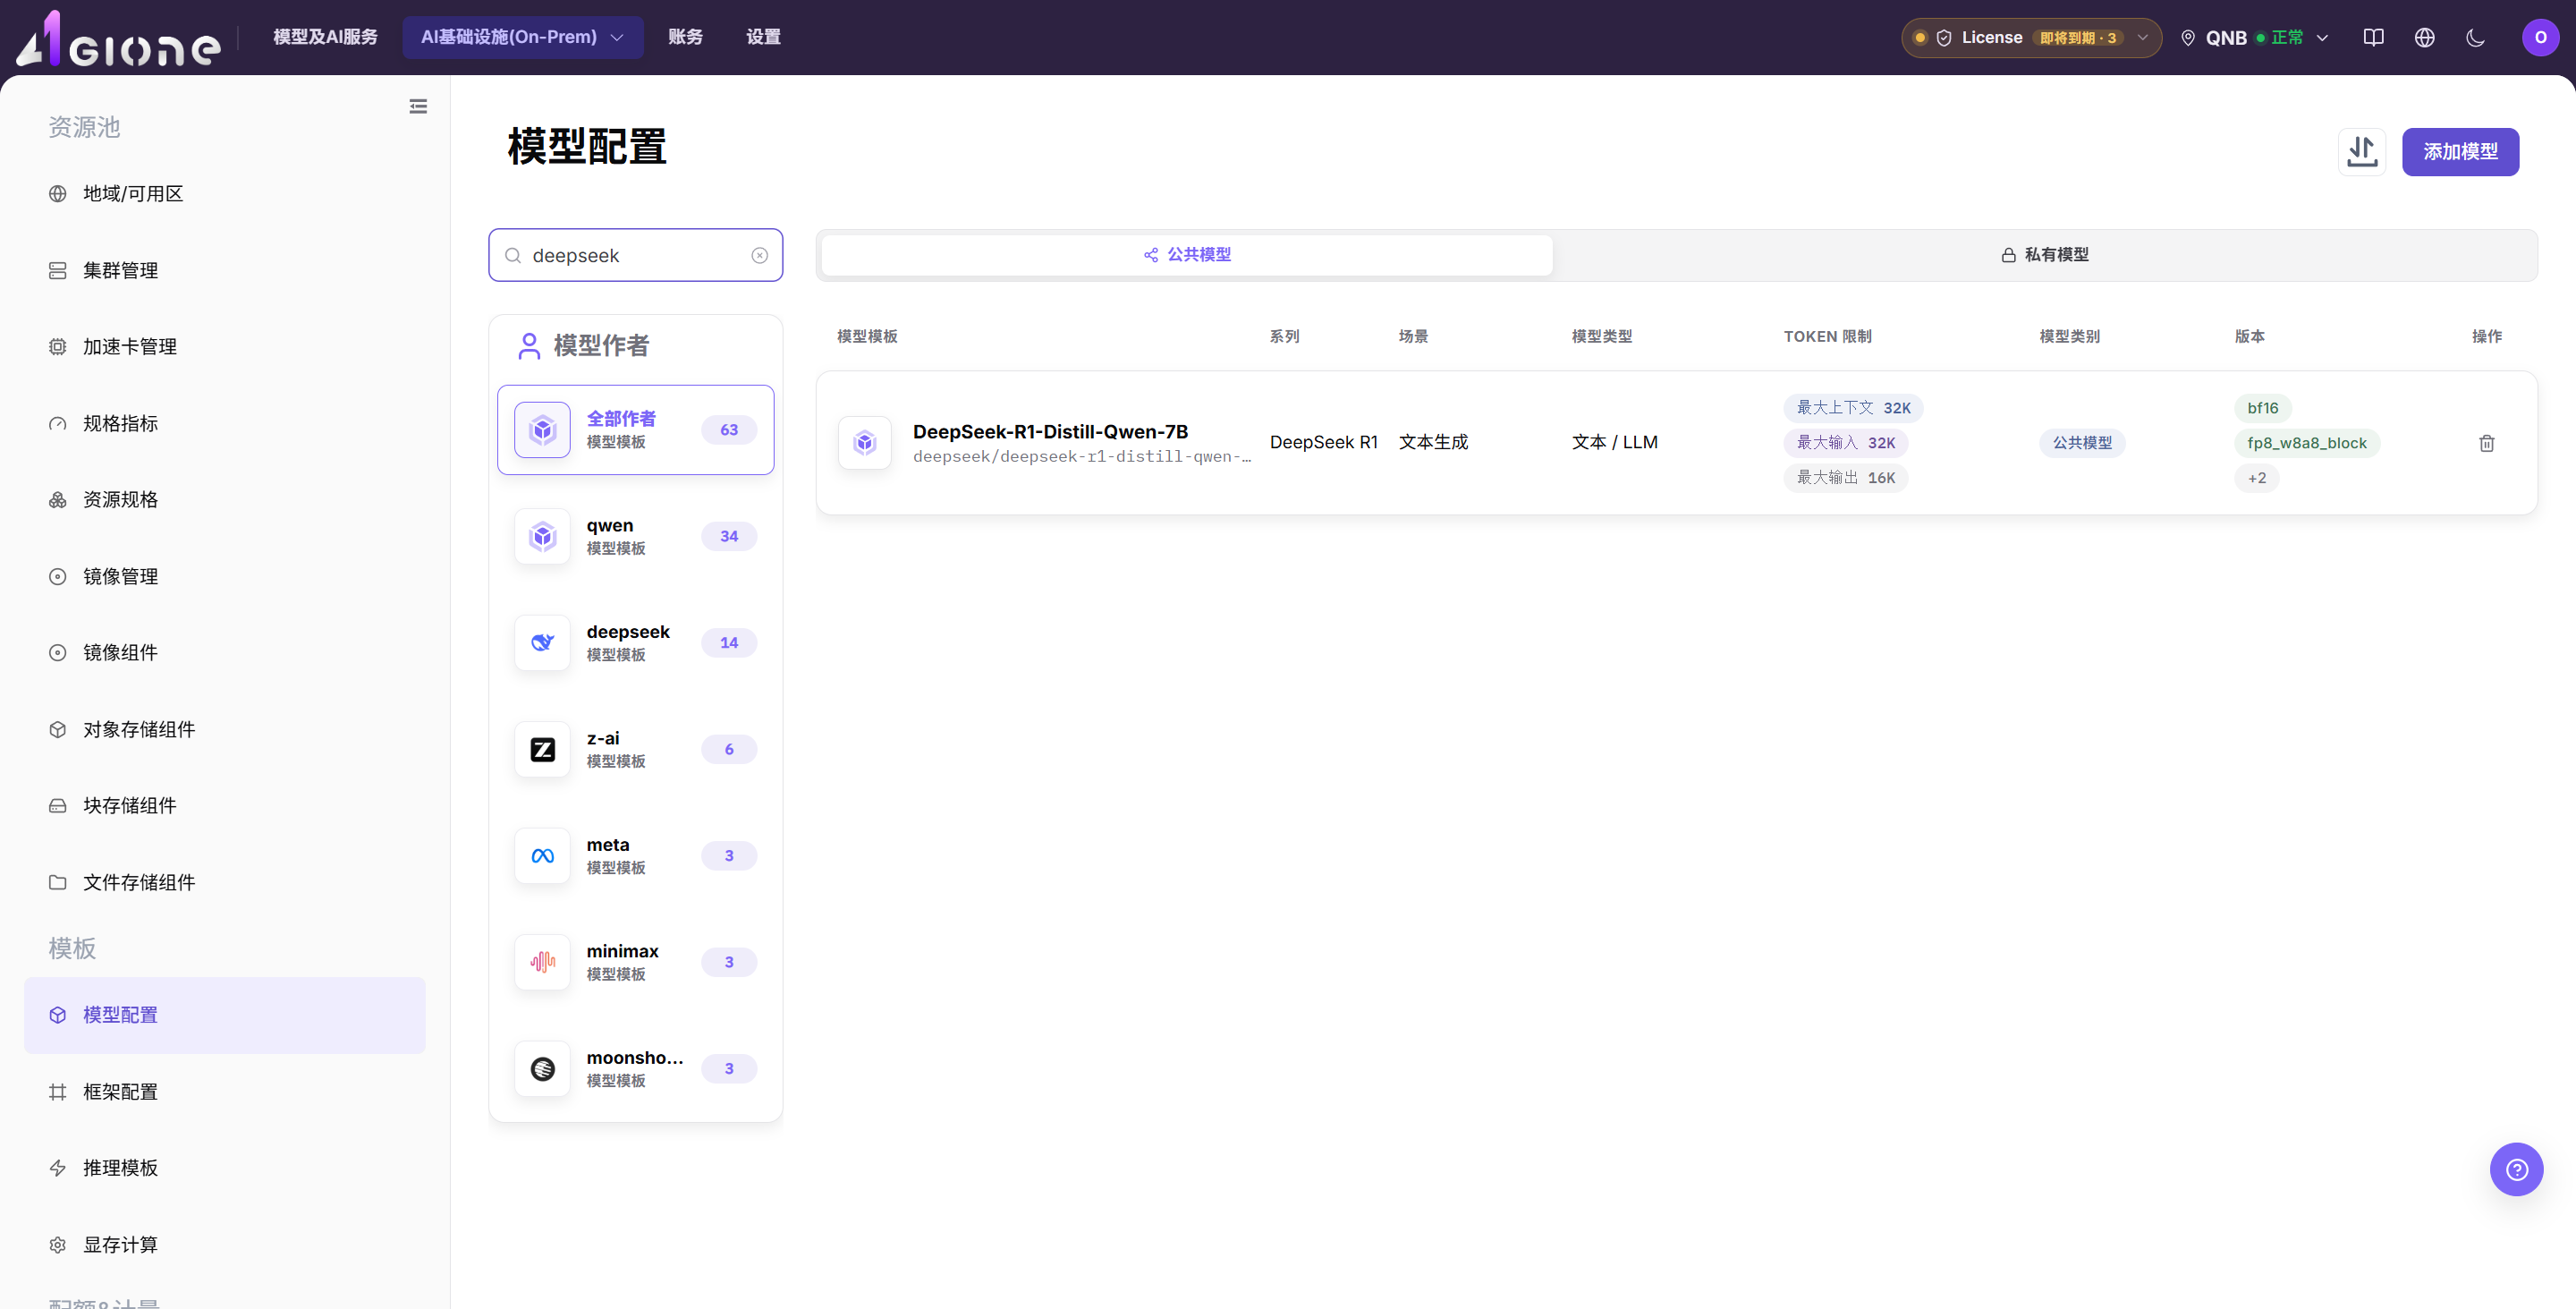
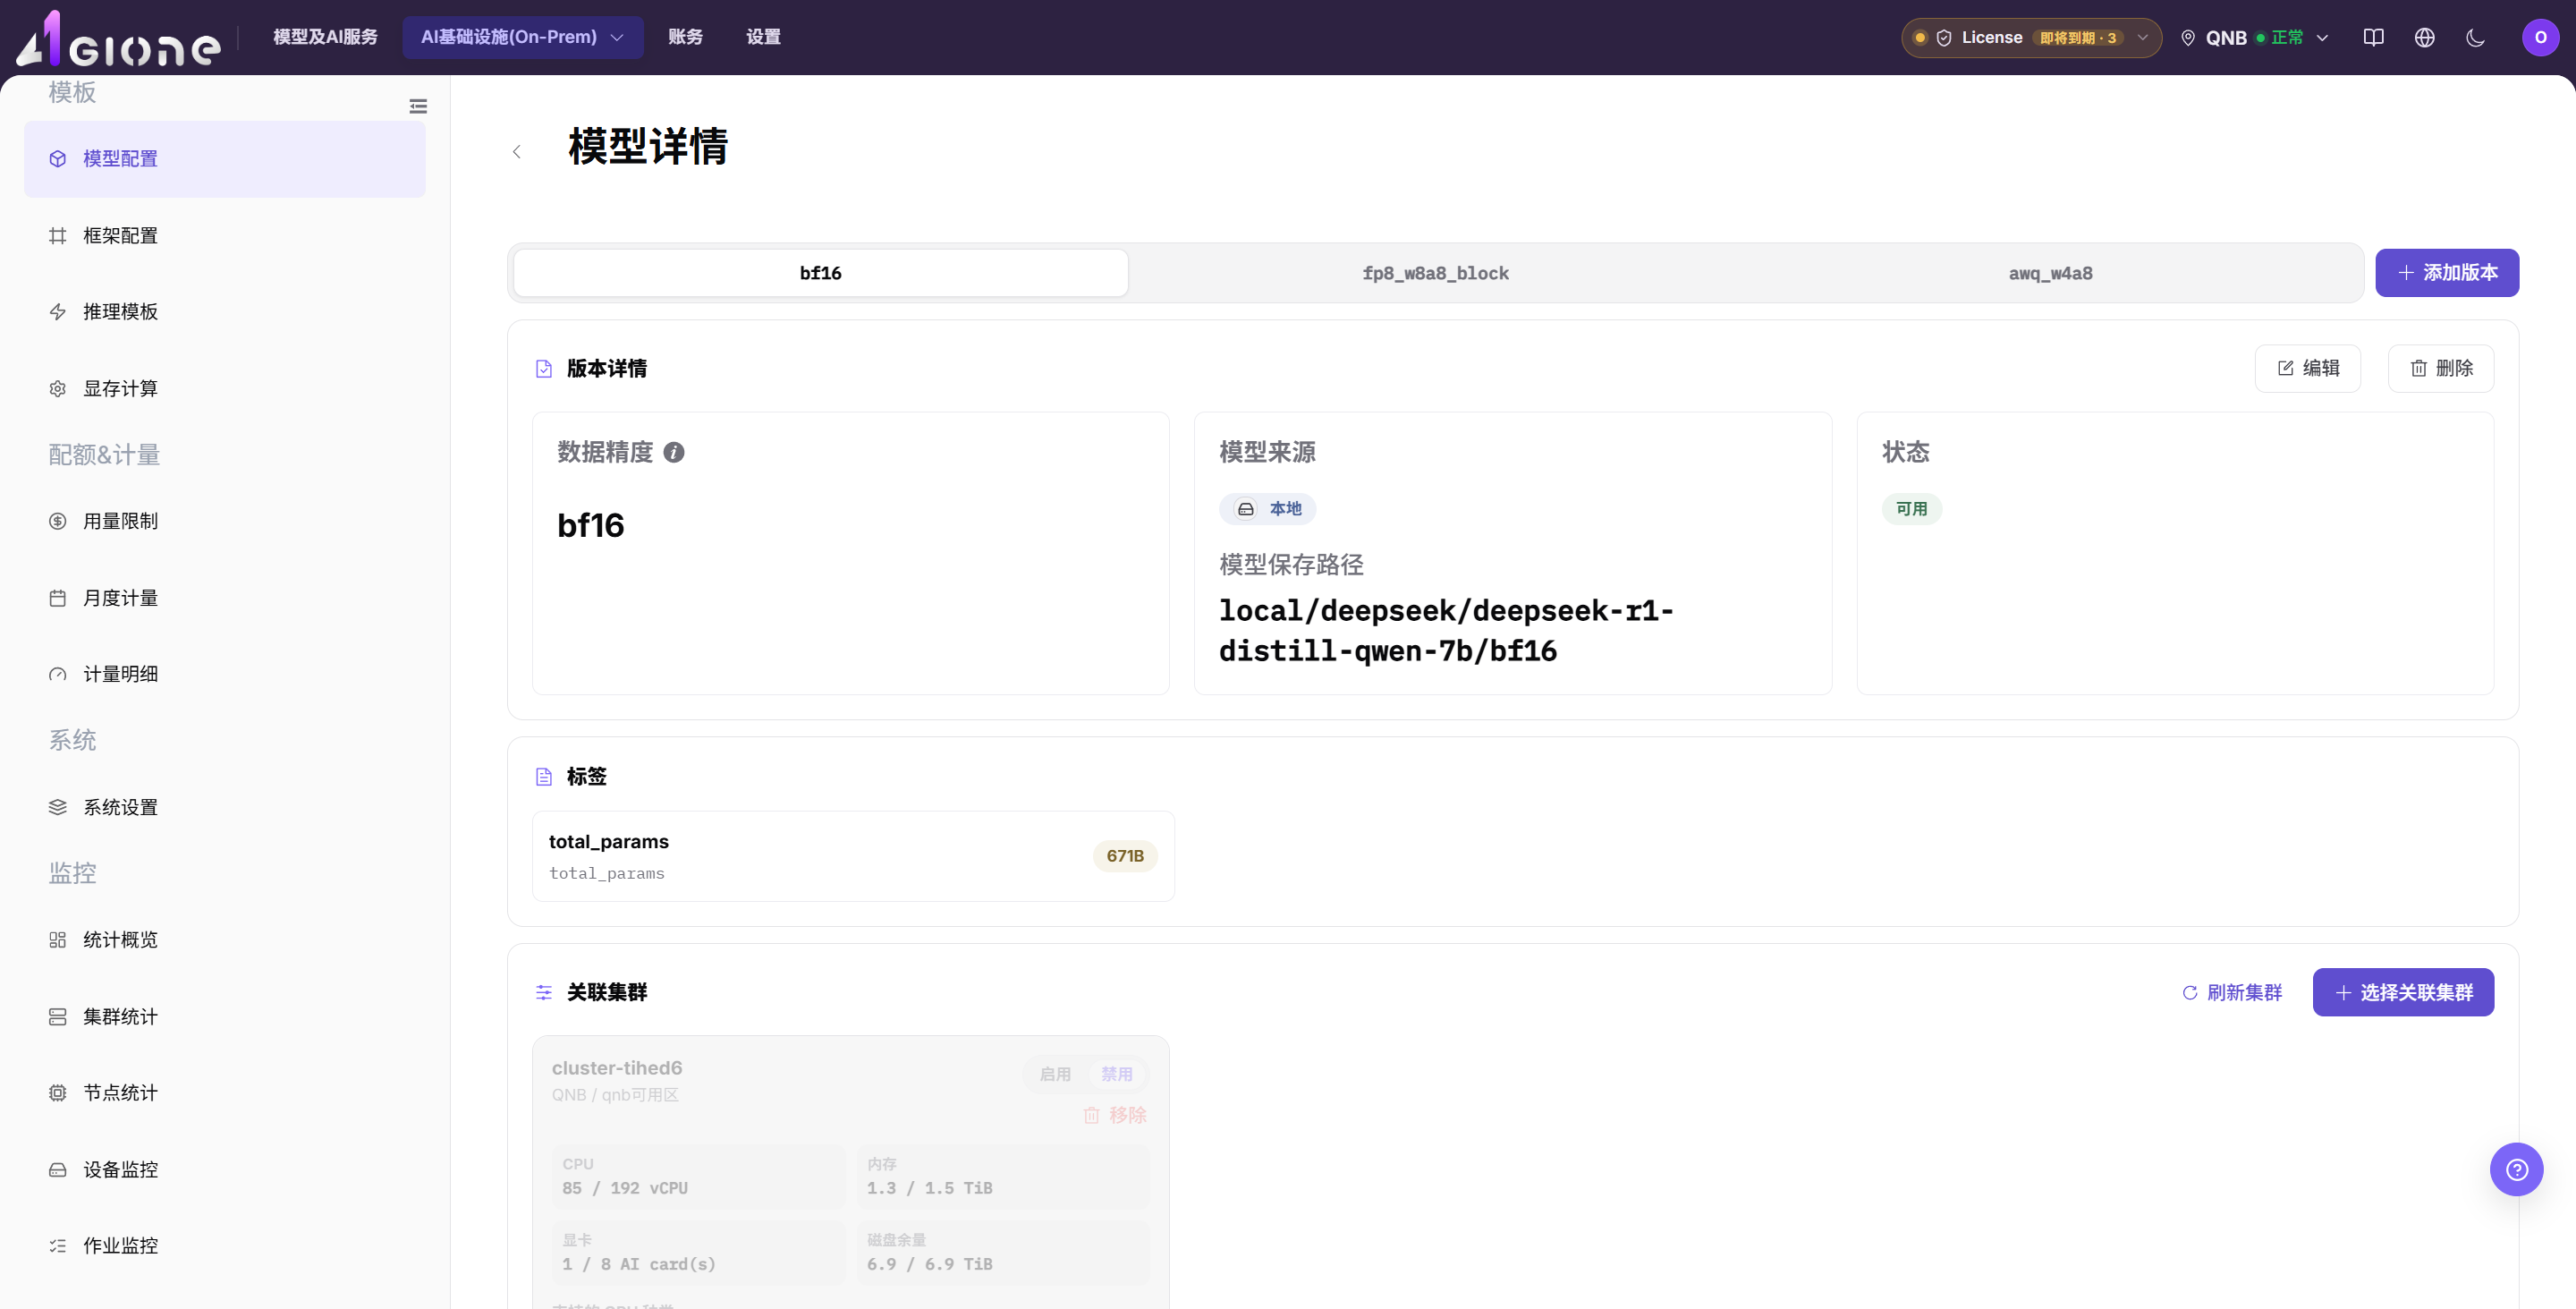
找到目标模型后,点击进入详情,向下滚动至 Select linked clusters。由于新模型尚未下载到当前集群,需点击目标版本对应的 Edit 按钮。
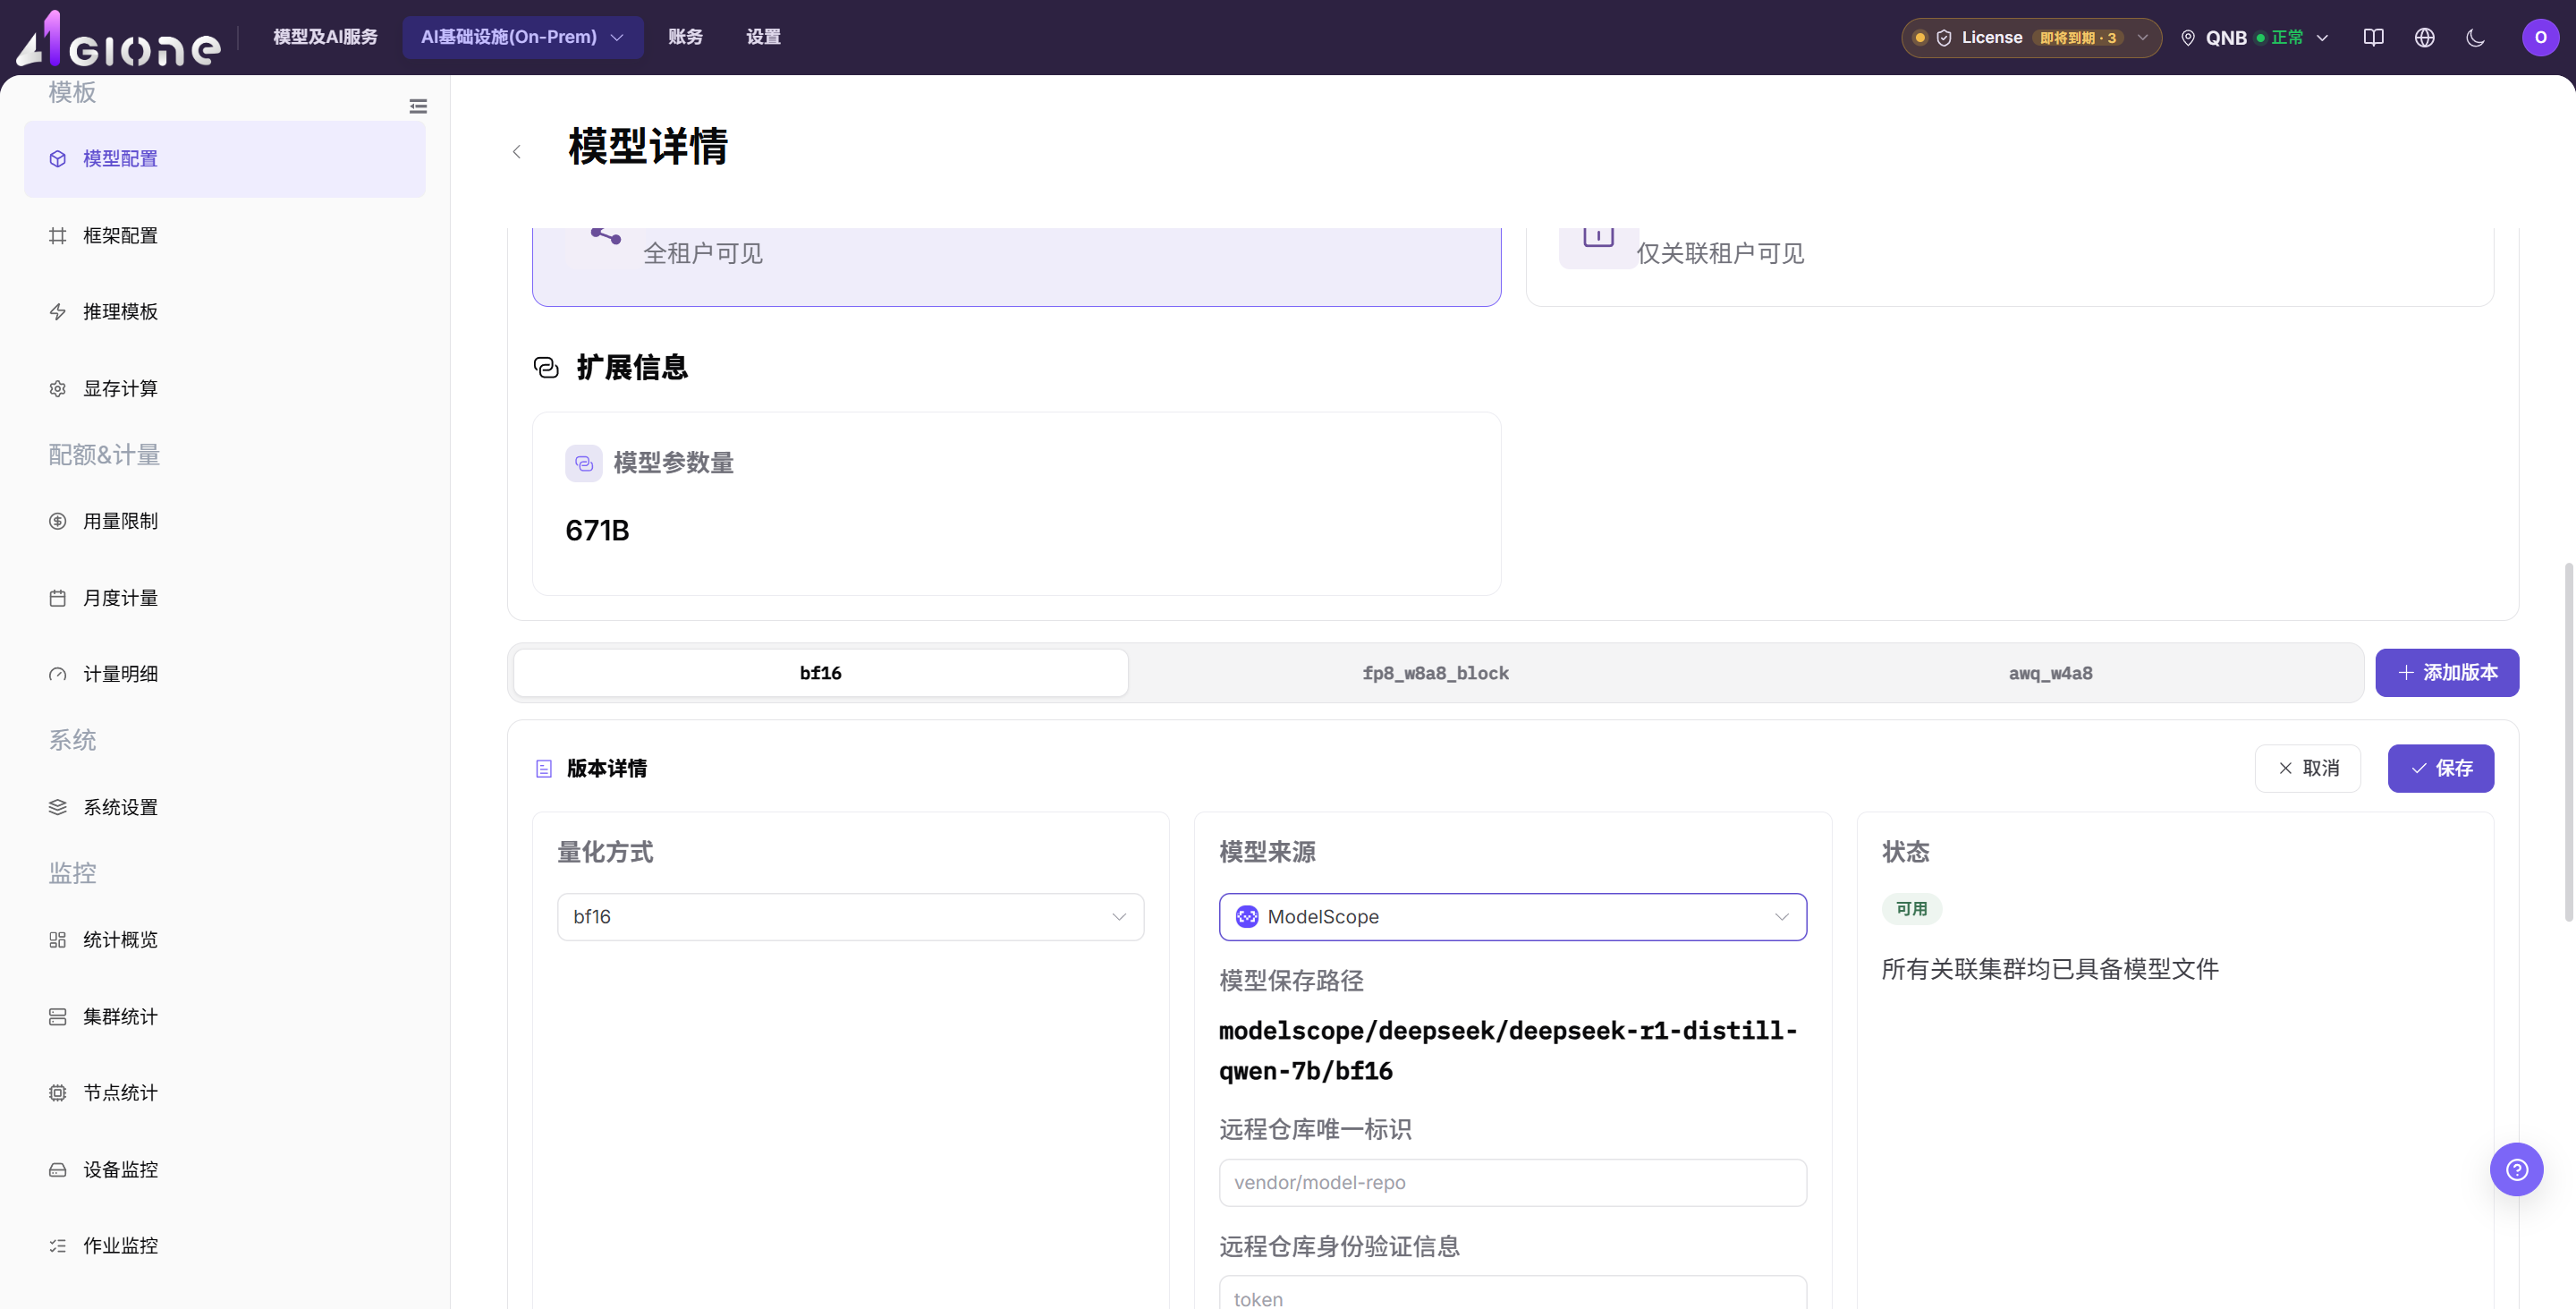
将模型来源从 Local 更改为 ModelScope 或 HuggingFace(当前环境建议选择 ModelScope 以确保网络顺畅)。填写目标模型的 Model ID,系统将使用它自动下载权重文件。
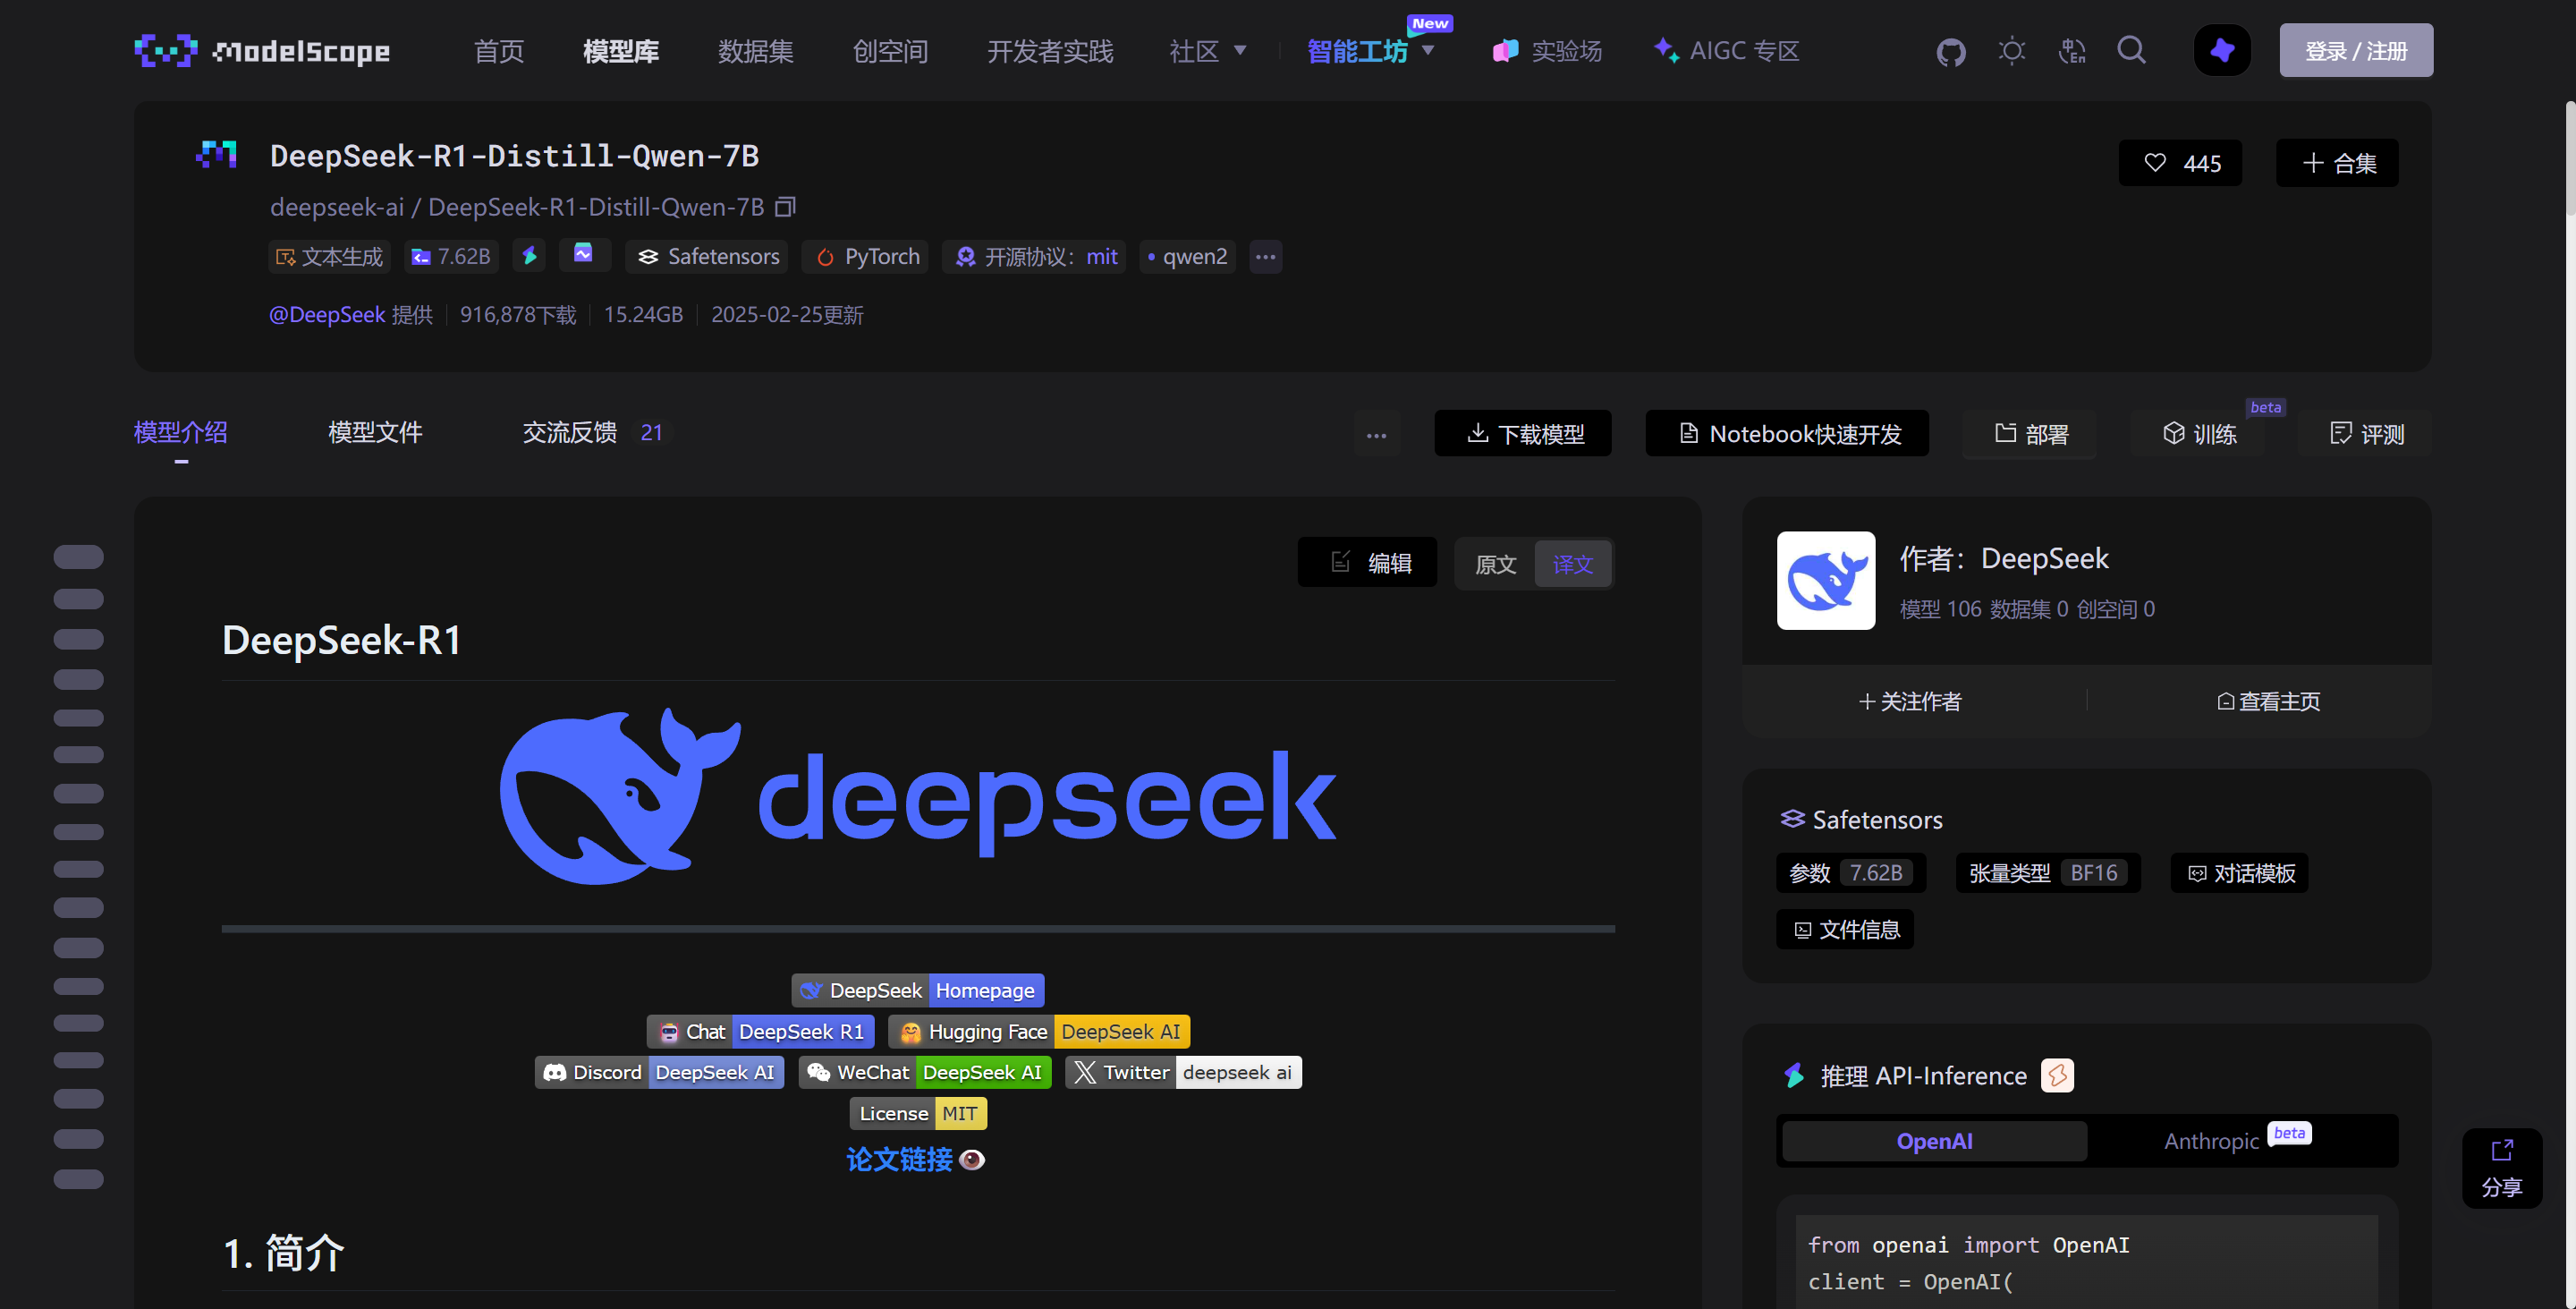
打开 ModelScope 官方社区,搜索模型并复制 Model ID,然后填入平台中。
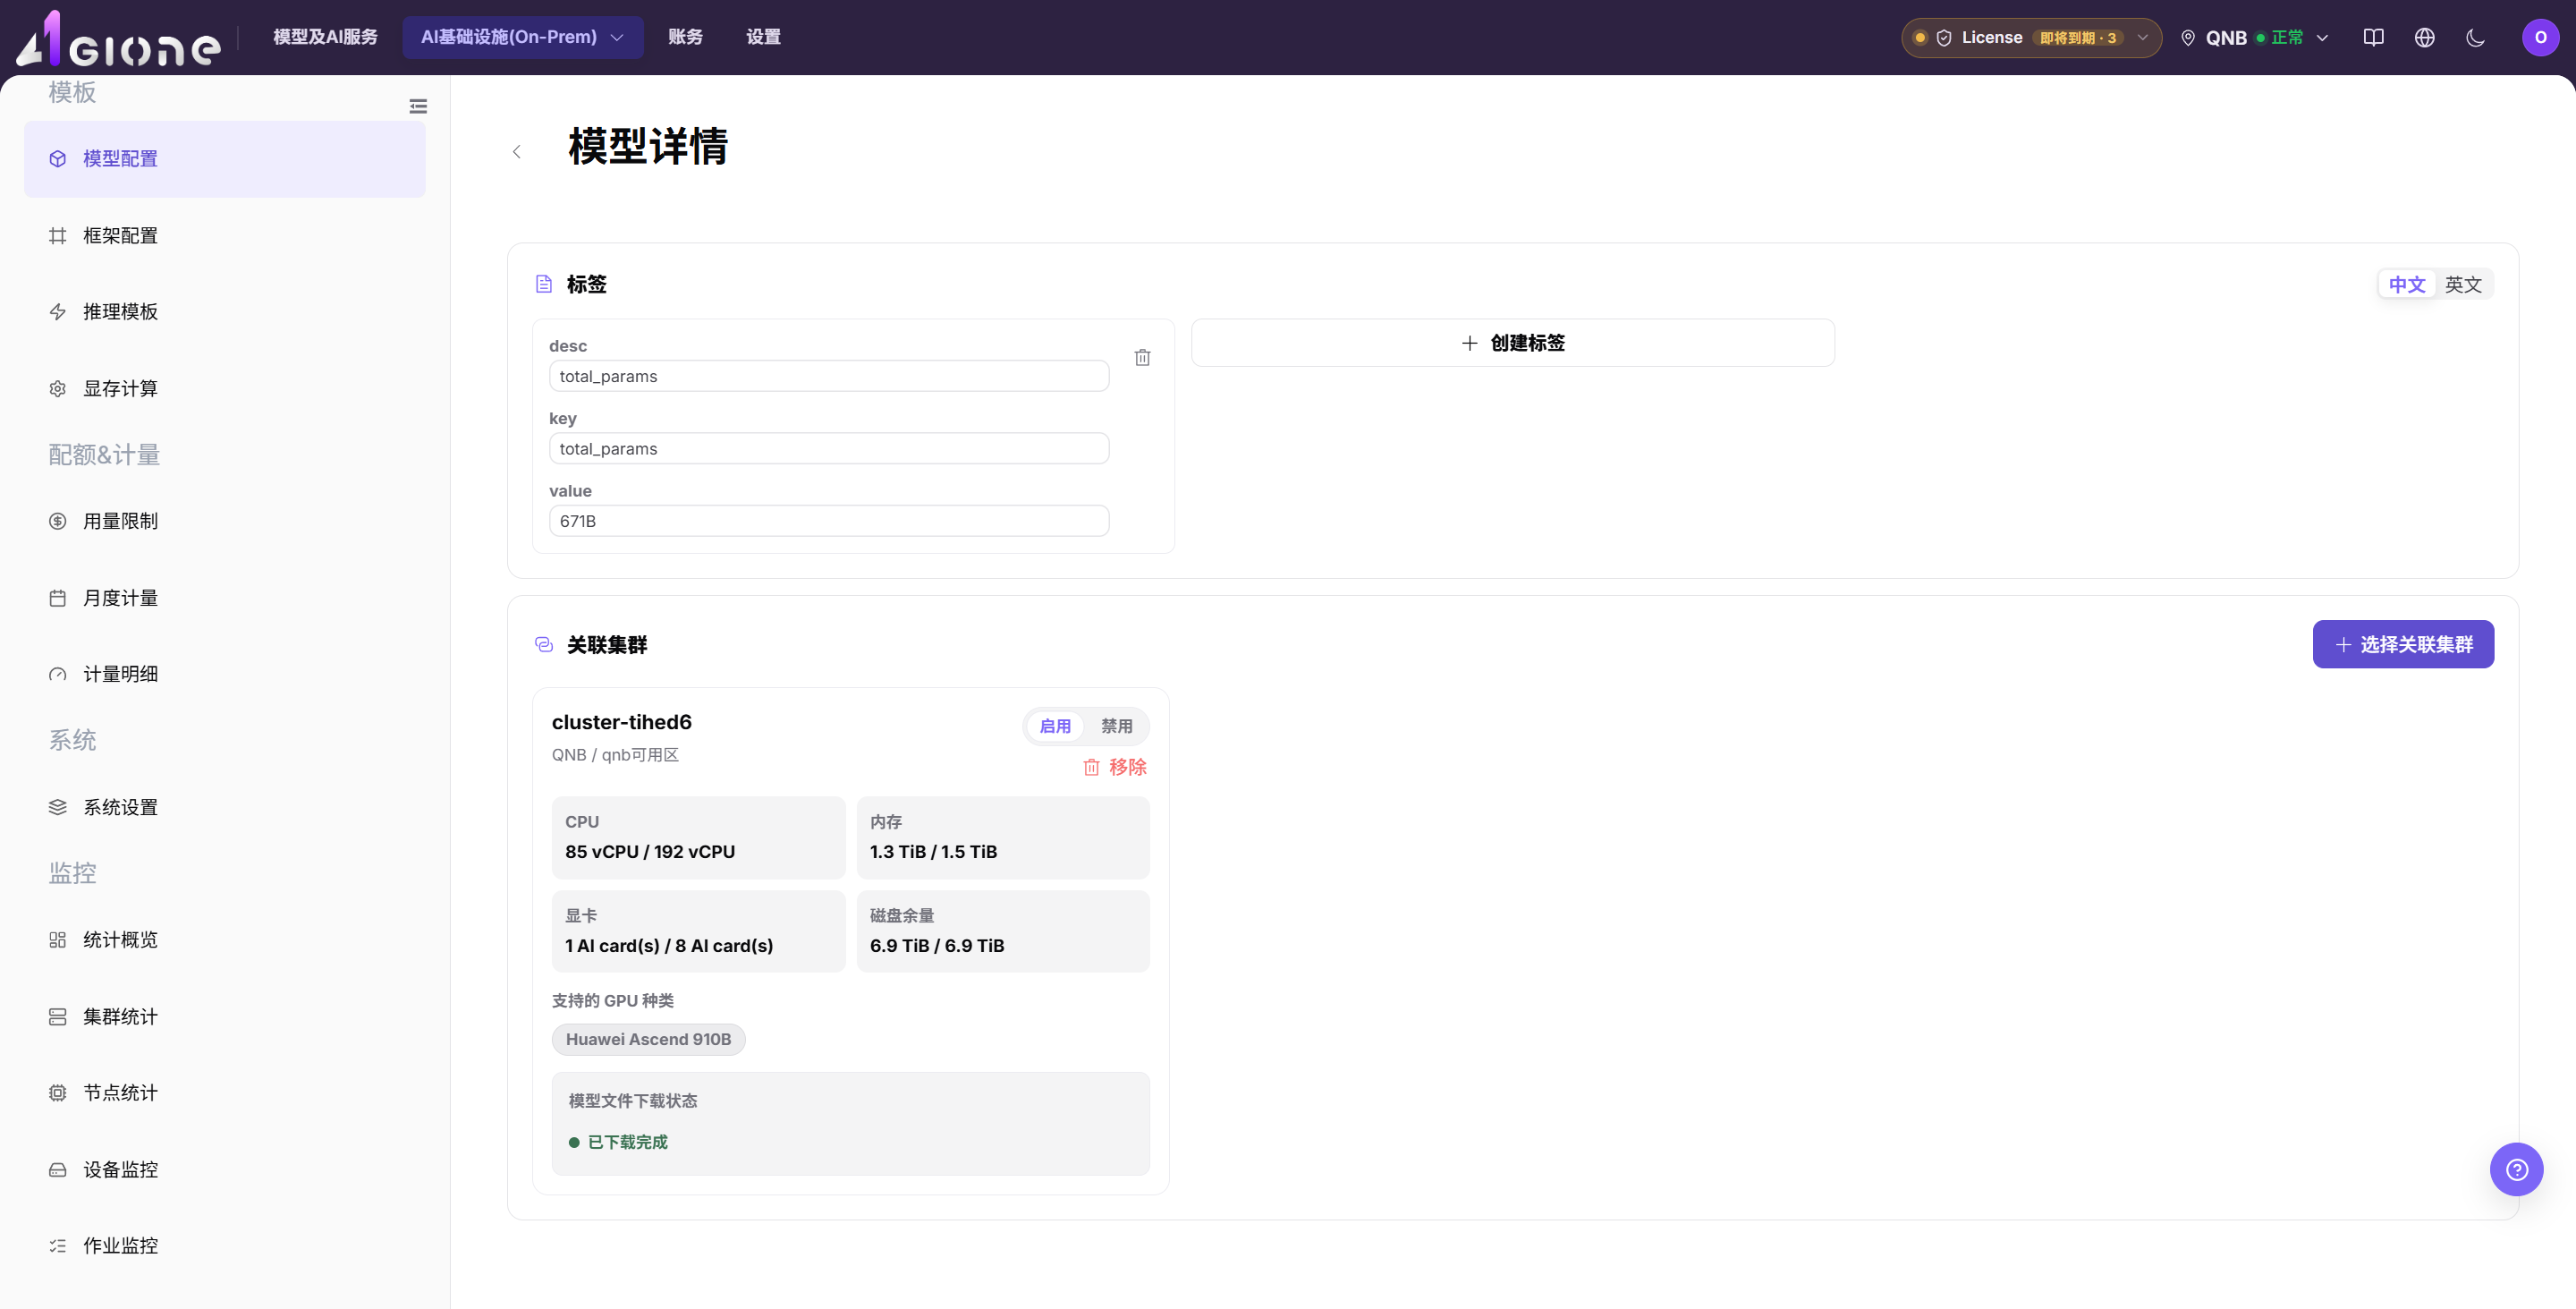
点击 Save 后系统开始自动下载模型。此时可以勾选 Enable after download,模型下载完成后将自动置为启用状态。
2. 创建推理模板(运营管理员)
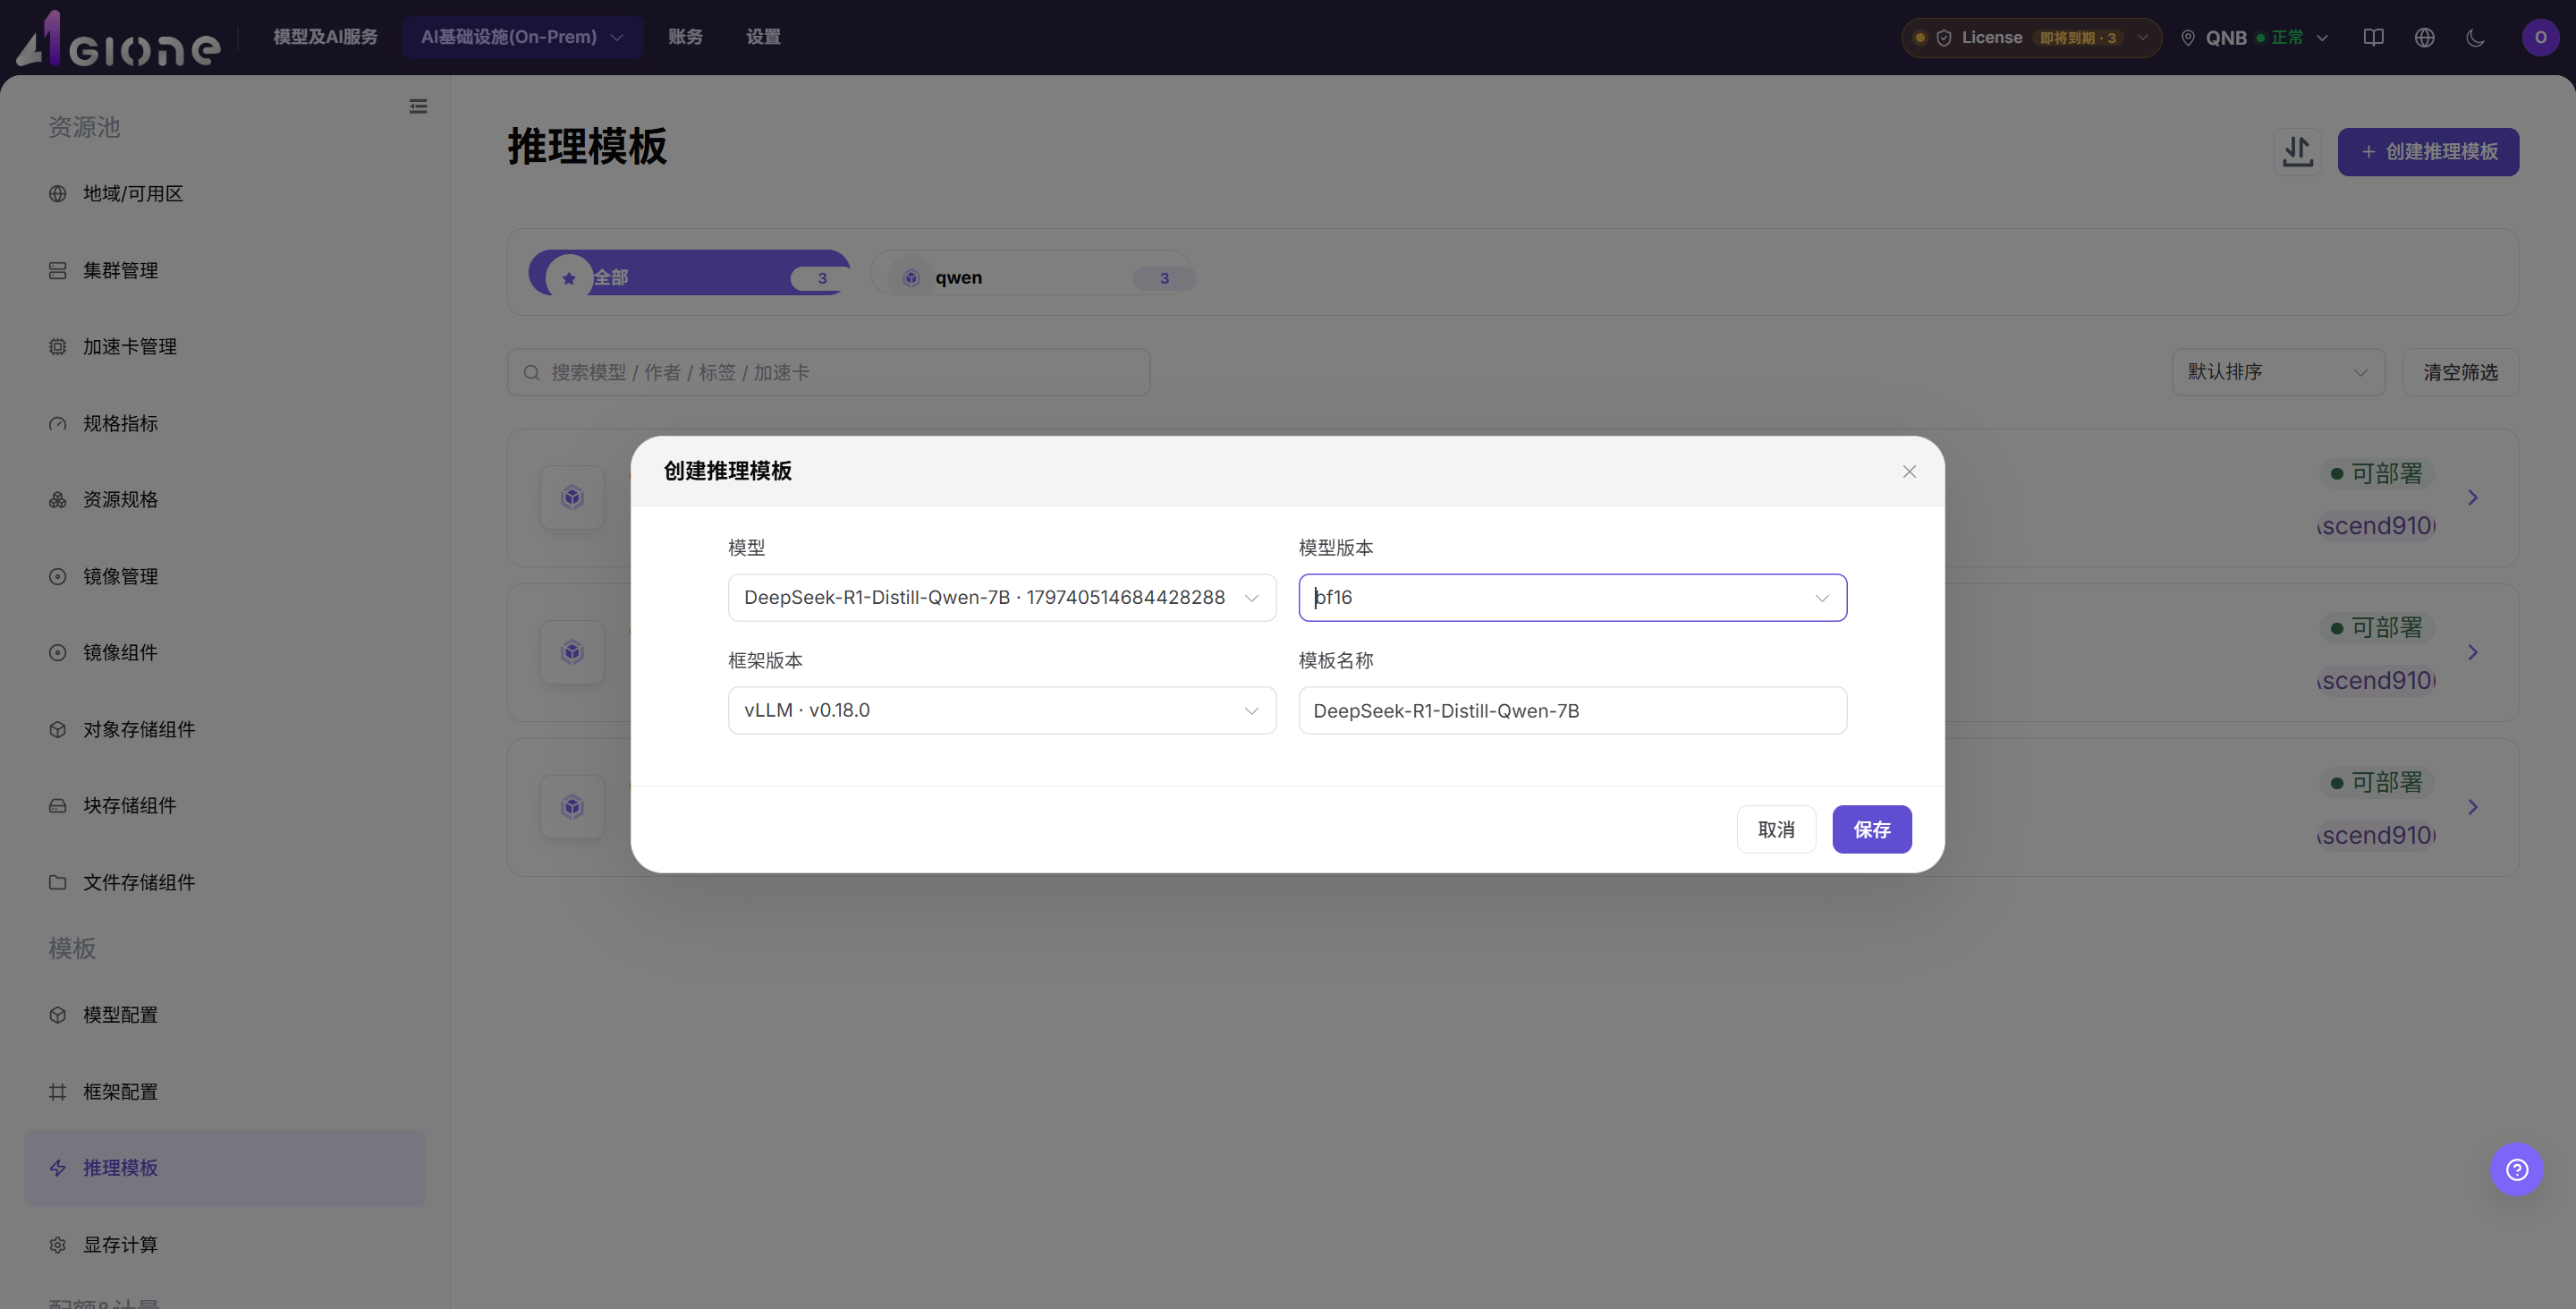
进入 AI-Infra > On-prem > 模板配置 > 推理模板 (Inference Templates) 页面,点击 New Inference Template,选择关联的模型与版本,指定推理框架,并输入模板名称。
在 Linked VRAM Factor 表单中点击 Edit,选择与模型架构匹配的显存系数表(如 Common Model Inference VRAM param table for vLLM)。
向下滚动到 Framework Relations 部分,点击 Edit,勾选绑定的算力卡规格(例如 Ascend 910B),确认后保存。
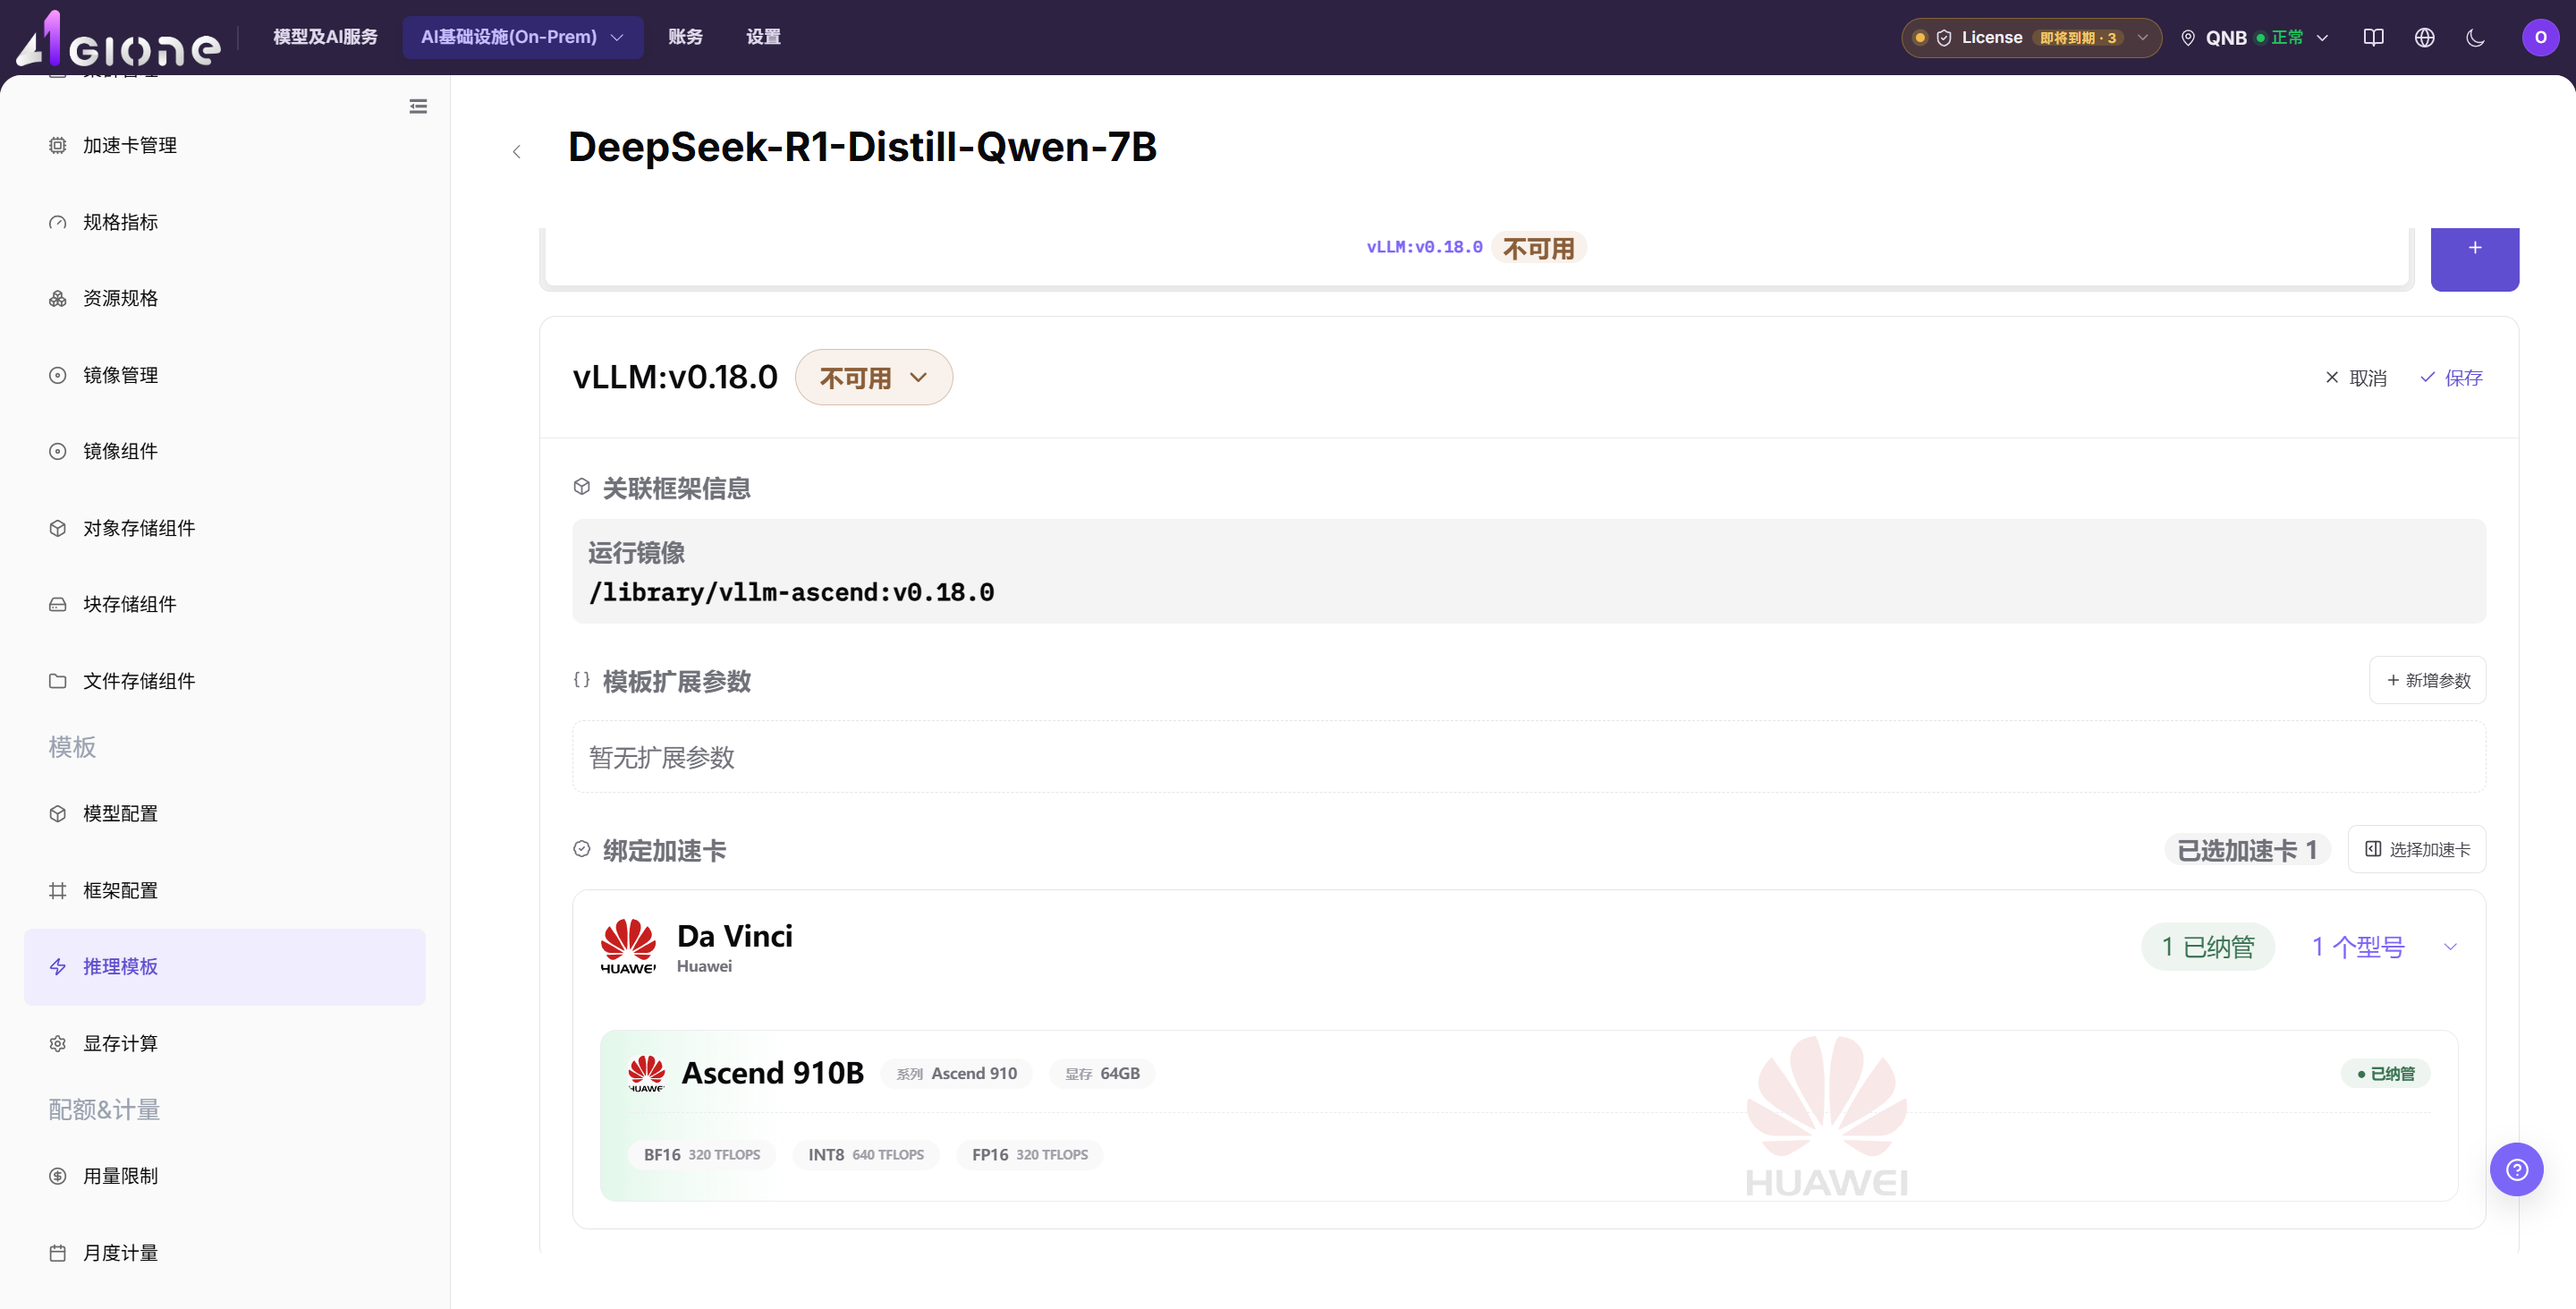
如需针对特定业务进一步优化推理吞吐或延迟,可在 Extra parameters 中按专业支持指引补充参数;常规测试保持默认即可。确认无误后,将模板状态变更为 Available。
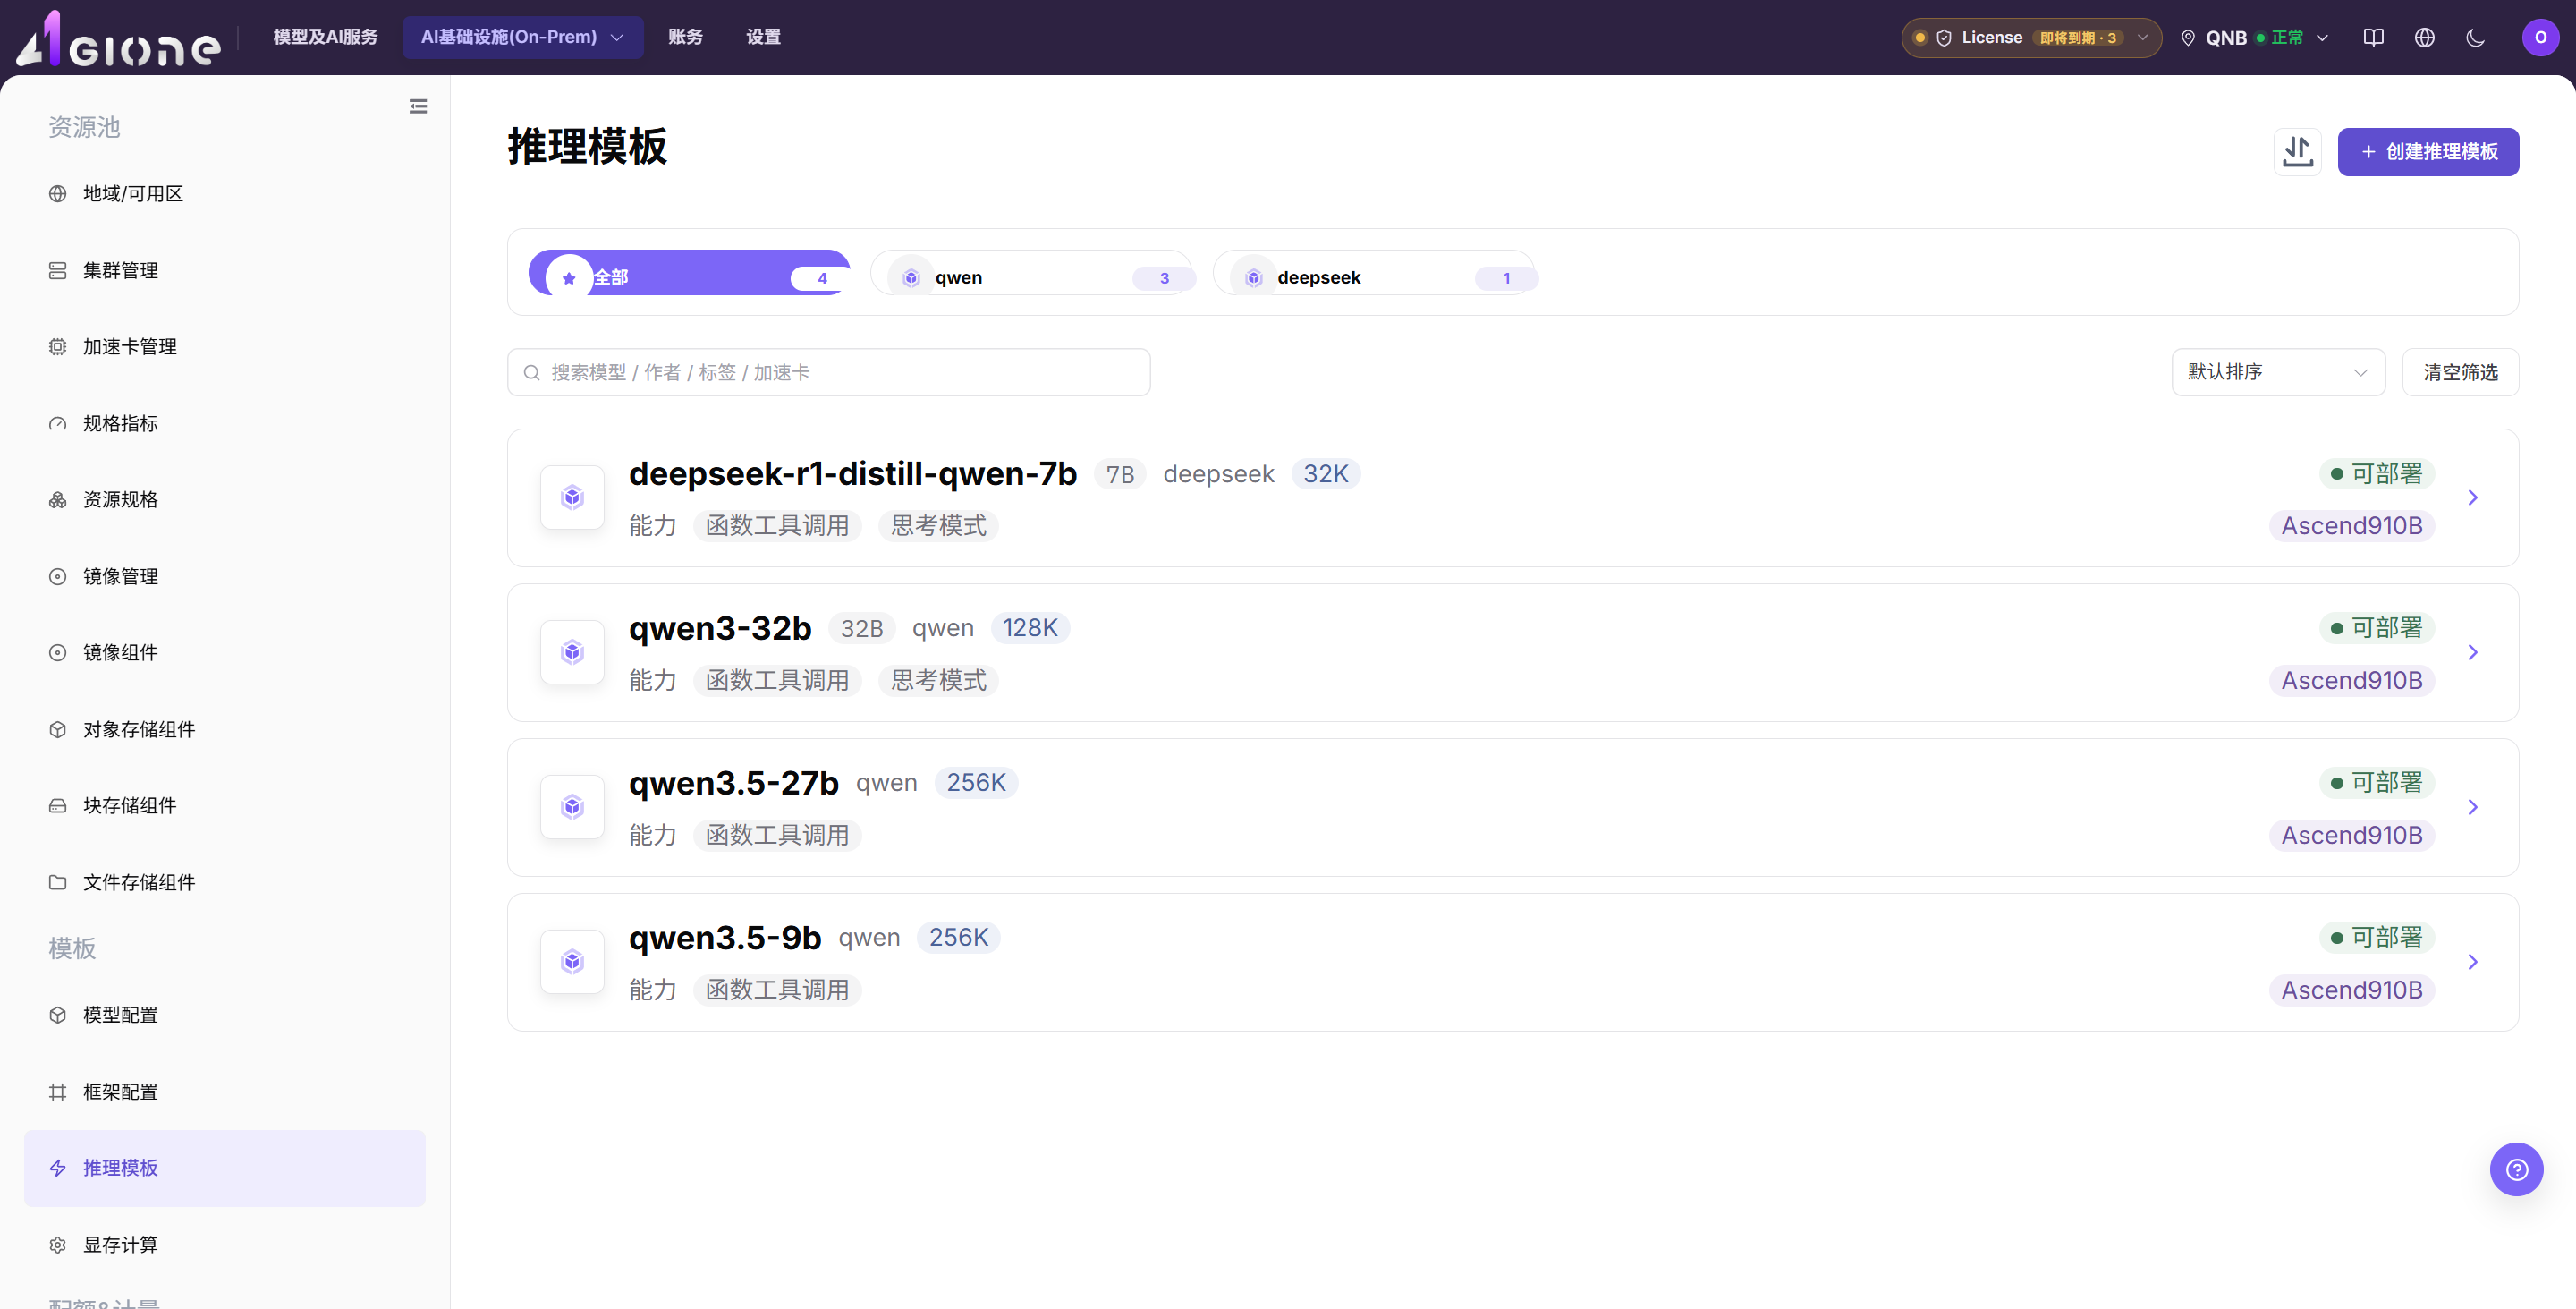
推理模板置为 Available 后,模型提供方即可参考“场景 A”中的步骤完成模型部署与服务发布。
完成检查
完成上述步骤后,按以下标准确认整个流程已闭环:
- 模板就绪:在 Inference Templates 列表中,新建的推理模板状态显示为 Available,关联的模型版本与加速卡规格正确。
- 实例运行正常:在 My Deployments 中,基于新模板创建的模型实例处于 Running 状态,服务端口正常暴露。
- API 与调用验证:在模型列表通过 Playground 成功进行对话交互,或通过
cURL发送请求能收到预期的模型推理结果。
常见失败分支
| 现象 | 优先检查 | 继续排查手册入口 |
|---|---|---|
| ModelScope 权重下载缓慢或失败 | 集群节点出网连通性、Model ID 拼写、目标集群存储容量及下载日志 | On-Prem 模型管理 |
| 推理模板无法置为 Available | 显存测算表关联、框架版本兼容性、加速卡规格绑定状态 | 推理模板配置 |
| 模型实例启动超时或报错 Crash | 目标节点 NPU 卡显存余量、并发与上下文配置、驱动与容器镜像版本 | 我的部署运维 |
| 发布协议测试 (Test) 失败 | 实例健康状态、服务端口暴露、协议路径及所选模型是否支持该协议 | 模型审核与发布 |
| cURL 或 Playground 无响应 | API Key 有效性、账户余额/配额、限流配置与网络防火墙策略 | 模型广场体验与调用 |